






在材料微观组织模拟领域,一个长期存在的"不可能三角"困扰着研究者:精度高、算得快、能扩展——商业相场软件往往只能满足其一,而开源代码又常因底层数值实现的粗糙让你在百万自由度面前束手无策。当PRISMS-PF以"无矩阵有限元+自适应网格+16384核强扩展"的技术组合横空出世时,这个三角被彻底打破:三维枝晶生长从"数周等待"压缩到"数小时出片",腐蚀坑扩展从"黑箱猜测"变为"逐帧追踪",而再结晶形核模型可以被你自由改写、即时验证。
作为美国能源部"材料基因组计划"(MGI)资助的旗舰开源代码,PRISMS-PF不仅免费,更在2020年npj Computational Materials上以开源论文形式发布后,成为连接"微观机理"与"宏观性能"的关键数字桥梁。然而,当你真正开始编译deal.II依赖链、运行2700万自由度的三维Cahn-Hilliard/Allen-Cahn耦合模型、或尝试与PRISMS-Plasticity进行紧耦合动态集成时,一个硬核现实会迅速浮现:PRISMS-PF对算力的贪婪,与其"无矩阵"带来的效率红利成正比。
本文将系统解析PRISMS-PF的核心算法、计算特征与应用场景,并给出面向个人研究者、材料计算课题组与国家级MGI平台的三级UltraLAB算力配置方案。
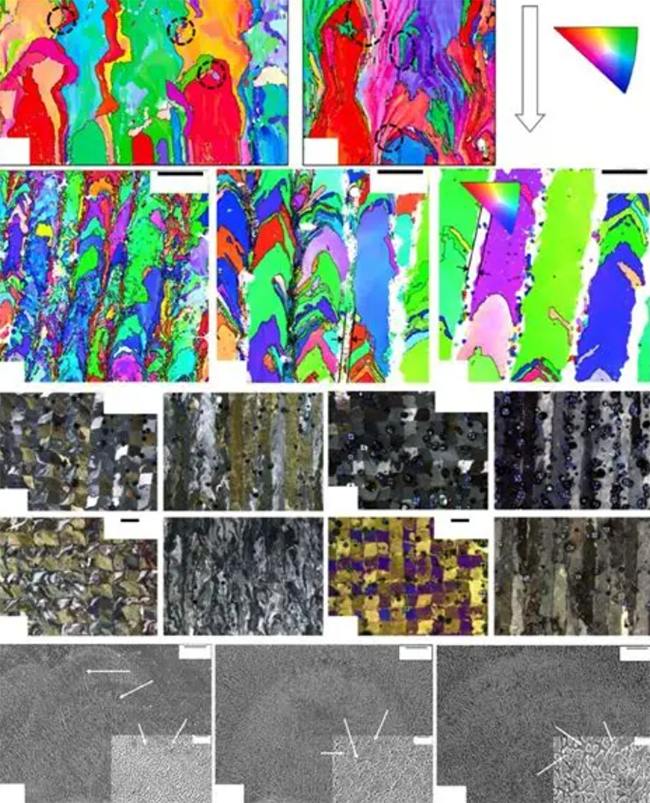
一、核心算法:不追界面,追"场"的数学魔法
PRISMS-PF的理论根基是相场法(Phase-Field Method)——它不直接追踪固液界面或晶界的位置,而是引入连续的场变量(序参量)描述整个系统。界面的移动、弯曲、分裂、合并,全部从场方程的演化中自然"涌现"。
1.1 两根支柱方程与一个发动机
| 方程 | 物理意义 | 数学形式 | 典型应用 | ||||
|---|---|---|---|---|---|---|---|
| Allen-Cahn方程 | 非守恒序参量演化(固/液、晶粒取向、相种类) |
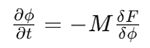 |
凝固、再结晶、腐蚀前沿推进 | ||||
| Cahn-Hilliard方程 | 守恒场变量扩散(溶质浓度) |
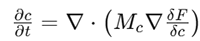
|
调幅分解、沉淀析出、溶质偏析 | ||||
| 总自由能泛函F | 驱动力发动机 | $F = \int \left[f(\phi,c,T) + \frac{\kappa_\phi}{2} | \nabla\phi | ^2 + \frac{\kappa_c}{2} | \nabla c | ^2 + E_{elastic} + E_{electric}\right] dV$ | 多物理场耦合的能量基准 |
关键洞察:PRISMS-PF支持任意数量的耦合控制方程。你只需在应用文件夹中定义自由能泛函 F 的具体形式,框架自动离散并求解Allen-Cahn/Cahn-Hilliard方程组,输出每时间步的场变量空间分布——相当于用代码"拍摄"微观组织演化的电影。
1.2 无矩阵有限元法(Matrix-Free FEM)——内存瓶颈的终结者
传统有限元代码的性能瓶颈来自全局刚度矩阵的显式组装与存储。当自由度数达到百万级时,稀疏矩阵的内存占用可达数十GB,且矩阵-向量乘法的访存带宽成为速度天花板。
PRISMS-PF基于deal.II库实现了无矩阵有限元方法:
-
不存储全局矩阵:利用有限元形函数的局部支撑性,在单元级别直接计算残差向量,通过单元接单元的"局部矩阵-局部向量"操作替代全局稀疏矩阵运算
-
内存占用极低:仅需存储场变量当前值与少量辅助向量,2700万自由度模型的内存占用可比传统方法降低10倍以上
-
计算通量受限于浮点性能而非访存带宽:完美契合现代CPU的高算力/低内存带宽架构特征
-
规模越大,优势越明显:基准测试显示,PRISMS-PF比传统有限差分代码快12倍,且加速比随问题规模增大而持续递增
1.3 自适应网格细化(AMR)——只在"有故事的地方"加密
相场模拟的计算量高度集中在界面区域(场变量梯度最大处),远离界面的单相区几乎无变化。PRISMS-PF集成基于p4est的分布式自适应网格管理:
-
自动检测场变量梯度,在界面附近加密至纳米级分辨率
-
在单相区保持微米级粗网格,节省90%以上无效计算量
-
细网格随界面移动自动迁移,无需人工重剖分
1.4 多级并行架构——从笔记本到超算无缝缩放
PRISMS-PF继承deal.II的并行基因,实现三级并行策略:
-
MPI分布式并行:计算域分块分配至数百~数千节点,支持16384核强扩展
-
共享内存并行(TBB/OpenMP):节点内部多线程加速单元级计算
-
SIMD向量化:利用AVX-512指令集,单时钟周期处理多个数据
基准实测:2700万自由度三维Cahn-Hilliard/Allen-Cahn耦合,48核并行效率71%;在腐蚀模拟中,>70万自由度体系展示超线性并行缩放(48核比24核快超过2倍),归因于缓存效率的跃升。
二、计算特点:为什么PRISMS-PF"既吃核又吃主频"
2.1 时间步长限制:隐式求解的"紧箍咒"
相场方程的界面宽度通常设定为纳米级(~1nm),为保证数值稳定性,时间步长受限于:
-
显式格式:受CFL条件严格约束,步长需达10−12 ~10−9 秒级,总步数爆炸
-
PRISMS-PF的隐式/半隐式格式:允许更大步长,但每个时间步需Newton-Raphson迭代求解非线性方程组,单次迭代计算量巨大
这意味着:PRISMS-PF不是"单次重载",而是"高频次中等负载"——数百万时间步 × 每步数十次Newton迭代 × 每次迭代的全域残差计算。
2.2 无矩阵方法的CPU主频敏感性
无矩阵方法避免了内存带宽瓶颈,但单元级的局部矩阵-向量运算高度依赖:
-
CPU浮点性能:高主频(>4.0GHz)直接提升每时间步的残差计算速度
-
AVX-512向量宽度:deal.II自动利用SIMD指令,宽向量寄存器可成倍增益
2.3 并行扩展性的"甜蜜点"与"天花板"
-
强扩展性(固定问题规模,增加核心数):48核效率71%,超过128核后因通信开销增加而递减
-
弱扩展性(问题规模与核心数同步增加):近乎线性,适合超算集群
-
超线性现象:在腐蚀模拟等特定场景中,缓存命中率提升导致实际加速比超过理论值
2.4 I/O与存储:被忽视的"时间小偷"
-
每时间步输出.vtk/.pvtu场数据,长时间瞬态模拟可产生TB级结果文件
-
自适应网格的层级结构需频繁读写p4est网格文件
-
NVMe SSD是保障I/O不成为瓶颈的刚需
2.5 编译构建的前置算力成本
从源码部署PRISMS-PF需先编译deal.II(≥9.1.1)+ p4est + CMake + MPI:
-
编译deal.II耗时数小时(单核)至数十分钟(16核并行)
-
对GCC/Intel编译器优化敏感,Intel oneAPI编译器可提升数值性能20~30%
-
磁盘空间:源码+编译产物+第三方库可达20GB+
三、应用场景:从凝固枝晶到腐蚀坑的"微观电影"
| 应用领域 | 核心物理过程 | PRISMS-PF的建模能力 | 典型计算规模 |
|---|---|---|---|
| 合金凝固 | 过冷熔体中枝晶形核与生长、溶质偏析、侧枝分枝 | Allen-Cahn描述固液界面 + Cahn-Hilliard描述溶质扩散 + 各向异性界面能 | 二维:百万自由度;三维:千万级自由度 |
| 静态再结晶 | 变形储能驱动下的晶粒形核与长大 | 多序参量描述不同取向晶粒 + 储存能场作为驱动力 | 二维/三维:数十万~数百万自由度 |
| 动态再结晶 | 变形与再结晶实时竞争(紧耦合) | PRISMS-MultiPhysics:PF↔CPFE双向数据交换 | 多尺度耦合,计算量翻倍 |
| 微电偶腐蚀 | 第二相颗粒周围基体优先溶解、腐蚀坑扩展 | 耦合电化学反应动力学 + 离子迁移扩散 + 金属/电解液界面演化 | 二维/三维:70万~500万自由度 |
| 沉淀析出 | 时效过程中GP区/亚稳相/稳定相的形貌演化 | 弹性应变能 + 各向异性界面能竞争决定平衡形状 | 三维:百万级自由度 |
| 晶粒生长 | 毛细力驱动的晶界迁移与拓扑变化 | 多晶粒多序参量 + 晶界能各向异性 | 二维/三维:数十万~数百万自由度 |
四、软件工具链与协同生态
| 层级 | 工具 | 功能定位 | 与PRISMS-PF的协同 |
|---|---|---|---|
| 核心框架 | PRISMS-PF (C++/deal.II) | 相场模型求解引擎 | 主引擎 |
| 有限元库 | deal.II (≥9.1.1) | 无矩阵FEM、AMR、并行通信 | PRISMS-PF的数值底座 |
| 网格管理 | p4est | 分布式自适应四叉树/八叉树网格 | 支撑AMR的并行网格动态重构 |
| 编译构建 | CMake + MPI | 跨平台编译与进程间通信 | 必备依赖 |
| 晶体塑性 | PRISMS-Plasticity | 三维CPFE,计算变形/织构/储存能 | 为PF再结晶提供初始条件;MultiPhysics紧耦合 |
| 多物理场 | PRISMS-MultiPhysics | PF + CPFE紧耦合动态集成 | 变形与组织演化实时交互 |
| 元胞自动机 | ExaCA | 宏观多晶组织凝固模拟 | PF校准生长动力学参数,ExaCA提供统计信息 |
| 热力学引擎 | OpenCalphad / PyCalphad | CALPHAD热力学计算 | 提供准确的自由能函数与相平衡数据 |
| 可视化 | ParaView | .vtk/.pvtu场数据后处理 | 枝晶/腐蚀坑/晶粒的3D渲染与动画制作 |
| AI参数化 | AMMBER (开发中) | 机器学习自动拟合相场参数 | 降低模型标定门槛 |
五、UltraLAB硬件配置推荐
PRISMS-PF原生运行在Linux,编译依赖重、运行阶段CPU密集且MPI并行扩展性强。针对其"高频次Newton迭代+无矩阵FEM+强MPI扩展"的三重特征,给出三级配置:
方案A:个人研究者/研究生入门 — 相场学习与轻量模拟
适用场景:PRISMS-PF安装学习、deal.II编译、二维凝固/调幅分解示例、ParaView可视化、轻量三维模型(<100万自由度)。
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Ryzen 9 7950X (16核32线程, 5.7GHz) 或 Intel Core i9-14900K (24核, 6.0GHz) | 高主频加速无矩阵FEM的单元级残差计算;16~24核支持本地MPI并行(mpirun -np 8~16) |
| 内存 | 64GB DDR5-5600 (2×32GB) | 支撑百万级自由度二维模型或轻量三维模型;编译deal.II不触发OOM |
| 系统盘 | 2TB NVMe Gen4 SSD | deal.II+PRISMS-PF源码+编译产物+ParaView安装 |
| 数据盘 | 4TB NVMe SSD | 存储瞬态模拟的.vtk时间序列数据 |
| 显卡 | NVIDIA RTX 4070 Ti Super 16GB | 16GB显存支撑ParaView流畅渲染百万级自由度三维枝晶/晶粒;CUDA加速可选 |
| 系统 | Ubuntu 22.04 LTS (原生) | deal.II/PRISMS-PF官方首选平台;candi一键编译脚本对Ubuntu支持最佳 |
| 编译器 | GCC 11+ 或 Intel oneAPI | Intel编译器优化无矩阵SIMD性能 |
预估性能:deal.II编译(16核并行)< 30分钟;二维凝固模拟(100万自由度,1000步)< 2小时;本地8核MPI并行效率>80%。
相关机型 UltraLAB AR350
方案B:材料计算课题组 — 三维组织演化与多物理场耦合服务器
适用场景:三维枝晶生长(500万+自由度)、腐蚀坑扩展、再结晶-变形紧耦合、沉淀析出形貌优化、5~10人共享。
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程) 或 Intel Xeon W9-3495X (56核, 液冷超频4.6GHz) | 96核:三维千万级自由度模型的MPI强扩展;56核+高主频:无矩阵FEM残差计算与Newton迭代加速 |
| 内存 | 256GB DDR5-4800 ECC (8×32GB) | 支撑2700万自由度三维Cahn-Hilliard/Allen-Cahn耦合;多用户并发内存冗余;ECC防数据错误 |
| 系统盘 | 4TB NVMe Gen4 SSD | 系统高可用,保护deal.II/PRISMS-PF编译环境 |
| 数据盘 | 8TB NVMe SSD阵列 | 长时间瞬态模拟的TB级.vtk输出;NVMe阵列保障ParaView快速加载时序数据 |
| 显卡 | NVIDIA RTX Pro 5000 32GB Ada | 32GB显存支撑ParaView实时渲染千万级自由度三维场数据;Ada架构编码器加速动画导出 |
| 网络 | 双10GbE以太网 | 连接课题组NAS与DFT计算集群(VASP→OpenCalphad→PRISMS-PF数据流) |
| 散热 | 双冷排水冷散热模块 | 96核/56核旗舰CPU满载功耗极高,液冷保障持续超频与7×24小时稳定性 |
| 系统 | Ubuntu 22.04 LTS + Slurm作业调度 | Linux原生编译优化;Slurm实现课题组多用户任务隔离与MPI资源分配 |
| 编译器 | Intel oneAPI (icc/icpc/ifort) | 最大化deal.II无矩阵SIMD性能与MPI通信效率 |
预估性能:三维凝固枝晶(500万自由度,5000步)< 12小时;腐蚀模拟(70万+自由度)展示超线性并行缩放;支持PRISMS-MultiPhysics紧耦合(PF+CPFE)百万自由度模型;10人并发提交无资源争抢。
相关机型 UltraLAB GR450P
方案C:国家级MGI平台/超算中心 — 全尺度材料数字孪生
适用场景:全零件凝固-组织-性能数字孪生、多尺度(DFT→CALPHAD→PF→CPFE)全链条、16384核强扩展测试、国产自主可控环境。
| 组件 | 配置规格 | 选型逻辑 |
|---|---|---|
| CPU | 双路 AMD EPYC 9684X (192核384线程) 或 双路 Intel Xeon Platinum 8592+ (128核256线程) | 超大规模MPI强扩展;弱扩展至数千核;作为集群头节点调度100+计算节点 |
| 内存 | 512GB~1TB DDR5-4800 ECC (16×64GB) | 支撑数千万自由度三维多物理场耦合;多尺度数据驻留 |
| 系统盘 | 8TB NVMe Gen4 SSD ( | 高可靠+高吞吐,承载操作系统+deal.II全家桶+PRISMS生态 |
| 数据盘 | 32TB NVMe SSD全闪存阵列 | 全零件数字孪生的海量时序场数据、EBSD实验标定数据、AI训练集 |
| GPU | 2× NVIDIA RTX Pro 6000 96GB | 192GB显存池:支撑ParaView实时渲染数千万自由度三维组织;双卡加速AMMBER AI参数优化 |
| 网络 | 双25GbE + 100GbE InfiniBand | 前端用户接入+后端MPI高速互联(GPUDirect RDMA可选) |
| 系统 | CentOS/RHEL 8 + Slurm + OpenMPI | 超算中心标准环境;PRISMS-PF官方验证平台 |
| 国产适配 | 支持统信UOS/银河麒麟 + 飞腾/鲲鹏编译适配 | 国防/核能项目自主可控;deal.II/PRISMS-PF源码可移植 |
| 扩展 | 预留PRISMS-Plasticity/ExaCA/OpenCalphad接口环境 | 支持多软件耦合的全链条材料计算 |
预估性能:2700万自由度三维Cahn-Hilliard/Allen-Cahn(192核MPI)< 6小时;16384核强扩展测试通过;支持全零件凝固数字孪生(空间×时间×成分×取向)< 24小时;统信UOS下全功能运行。
相关机型 UltraLAB GA660M
六、结语:无矩阵的自由,需要算力的底气
PRISMS-PF用"无矩阵有限元"解放了内存瓶颈,用"自适应网格"解放了无效计算,用"开源模块化"解放了物理模型的定义权。但这份自由是有代价的:当你把界面分辨率推到纳米级、把计算域扩展到毫米级、把耦合方程增加到五场以上时,Newton迭代的次数、MPI通信的频次、ParaView渲染的数据量,都会瞬间拉满你的算力底线。
从deal.II的编译等待,到千万自由度每时间步的残差计算,再到16384核并行的通信开销——PRISMS-PF的每一次强大功能释放,都在考验硬件的极限。UltraLAB深耕高性能Linux工作站与异构计算平台,针对PRISMS-PF/deal.II/p4est/ParaView/PRISMS生态的全栈算力需求,提供从单卡桌面工作站到多节点GPU集群、从Ubuntu开发环境到国产Linux自主可控平台的全系列硬件解决方案。
我们不仅交付算力,更交付"开机即用"的材料计算工程化能力——预装Ubuntu 22.04 LTS + Intel oneAPI + deal.II优化编译版 + PRISMS-PF全家桶 + ParaView + OpenCalphad接口,配置Slurm作业调度与多用户隔离,让科研团队把精力聚焦于相场模型创新与材料机理发现,而非编译报错与并行死锁。
开源框架赋予你定义微观组织的自由,UltraLAB赋予你驾驭微观组织的算力。
如需针对PRISMS-PF凝固模拟、腐蚀预测、再结晶建模或PRISMS-MultiPhysics紧耦合场景定制硬件配置清单,欢迎联系UltraLAB技术团队获取详细技术白皮书与Benchmark测试报告。
关键词: PRISMS-PF、相场模拟工作站、无矩阵有限元、deal.II并行计算、自适应网格细化、凝固枝晶模拟、再结晶建模、微电偶腐蚀、材料基因组计划、开源材料计算、国产自主可控、UltraLAB
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


