






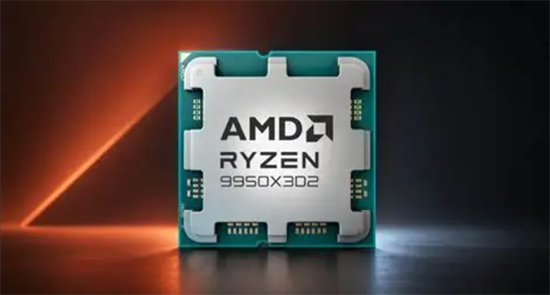
图 1:AMD 锐龙 9 9950X3D2 双缓存版——MSDT 平台首款双 CCD 3D V-Cache 处理器
一、产品定位与核心规格
2026 年 4 月 22 日,AMD 正式发售锐龙 9 9950X3D2 Dual Edition(双缓存版),这是全球首款搭载双路第二代 AMD 3D V-Cache 技术的台式机处理器,也是 AM5 平台的收官旗舰之作。它专为开发者、创作者与游戏玩家打造,面向复杂编译、大规模模拟与内存密集型工作流,国行建议零售价为 6999 元。
| 规格项 | 参数 | 规格项 | 参数 |
|---|---|---|---|
| 架构 | Zen 5(Granite Ridge) | 核心 / 线程 | 16 核 / 32 线程(SMT) |
| 最高加速频率 | 最高可达 5.6 GHz | 基准频率 | 4.3 GHz |
| L1 缓存 | 1280 KB | L2 缓存 | 16 MB |
| L3 缓存 | 192 MB(双 3D V-Cache) | 总缓存 | 208 MB |
| 默认 TDP | 200 W | 满载插槽功耗(PPT) | 270 W |
| 核心制程 | TSMC 4nm FinFET | I/O Die 制程 | TSMC 6nm FinFET |
| 封装芯粒数 | 3(双 CCD + IOD) | 晶体管数量 | 约 166.3 亿 |
| 插槽 / 平台 | AM5 | 内存支持 | DDR5-5600(甜点 DDR5-6000) |
| 指令集 | x86-64、AVX-512、AVX2、FMA3 等 | 核显 | AMD Radeon Graphics(2 CU,2200 MHz) |
| 超频 | 不锁频,支持 PBO / 曲线优化器 / EXPO | 芯片组 | X870E / X870 / B850 / X670E / B650 等 |
| 操作系统 | Windows 11 / 10、RHEL、Ubuntu x86-64 | 发售日期 / 售价 | 2026-04-22 / ¥6999 |
二、计算特点:把"数据中心级缓存"装进桌面
2.1 双 CCD 满配 3D V-Cache,从根上消除调度不确定性
此前的 16 核 X3D 处理器(如 9950X3D)采用非对称设计:只有一个 CCD 堆叠 64MB V-Cache,依赖驱动与调度器把缓存敏感型线程"搬运"到大缓存核心上,特定场景下可能出现调度误判。9950X3D2 直接在两个 CCD 上各堆叠一片 64MB SRAM 芯片,架构层面彻底抹平差异:
- 每 CCD:32MB 原生 L3 + 64MB 3D V-Cache = 96MB L3
- 全片 L3 合计 192MB,加上 16MB L2,总缓存 208MB
- 任何核心、任何线程落在哪个 CCD 上,都能吃到满血大缓存
2.2 缓存即性能:让更多数据离核心更近
208MB 总缓存意味着大规模数据集、编译中间产物、仿真网格可以长时间驻留在片上,显著降低对 DDR5 内存的访问频次。AMD 官方表示,这让处理器可以减少内存瓶颈、缩短处理周期——对内存延迟敏感的工作负载而言,缓存命中的提升直接转化为吞吐量的提升。
2.3 200W TDP:用功耗预算换持续性能释放
相比 9950X3D(170W / 加速 5.7GHz),双版本最高加速频率微调至 5.6GHz,但 TDP 提升至 200W。代价是极轻微的单线程损失,收益是更高的持续多线程功耗预算:长时间满载的编译、渲染、仿真任务可以获得更稳定的全核频率曲线。
2.4 完整 AVX-512 与 AI Ready
Zen 5 完整支持 AVX-512 指令集,配合 FMA3、AES 等扩展,在科学计算、AI 推理、密码学与多媒体编码中拥有更高的 SIMD 吞吐效率;同时 Ryzen 9000 系列定位 AI Ready,可与 Radeon 显卡协同提供本地 AI 加速能力。
 图 2:第二代 3D V-Cache 混合键合堆叠结构(每 CCD 64MB)
三、应用场景:谁需要 208MB 缓存
| 应用场景 | 负载特征 | 缓存收益逻辑 | 推荐指数 |
|---|---|---|---|
| 大规模代码编译 | 高并发、海量小文件、构建图遍历 | 编译单元与符号表驻留缓存,减少内存往返 | ★★★★★ |
| 3D 渲染 / 动画 | Blender、V-Ray、C4D 长时间全核满载 | 200W 功耗预算支撑稳定全核频率 + 场景数据缓存 | ★★★★★ |
| 视频剪辑与调色 | 4K/8K 时间线、特效合成、编解码 | AVX-512 加速编解码,缓存容纳预览帧数据 | ★★★★☆ |
| 科学计算 / CAE | GROMACS 分子动力学、ANSYS、COMSOL 仿真 | 分子邻接表/网格数据驻留缓存,GROMACS 实测提升显著 | ★★★★★ |
| 数据压缩 / 归档 | 7-Zip / LZMA 高压缩级别 | 字典与窗口数据完全驻留 208MB 缓存,提升远超均值 | ★★★★★ |
| 本地大模型推理 | llama.cpp / LM Studio CPU 推理 | 权重分片驻留缓存,降低内存带宽依赖,提升 tok/s | ★★★★☆ |
| 虚拟机 / 容器开发 | 多 VM 并行、CI/CD 本地流水线 | 16 核 32 线程 + 大缓存减少 VM 间缓存争抢 | ★★★★☆ |
| 电竞高帧率游戏 | CPU 瓶颈型游戏(CS2、Valorant、模拟类) | X3D 大缓存传统强项,双版本与 9950X3D 帧率基本持平 | ★★★★☆ |
四、算法优势:为什么大缓存等于快
- 时间局部性 × 空间局部性最大化:编译、压缩、图算法、分子动力学本质都是"反复访问热点数据"。208MB 片上缓存让热点工作集(Working Set)整体驻留,L3 命中率提升直接压低平均内存访问延迟。
- 消除双 CCD 调度开销:对称缓存设计使操作系统调度器无需感知 CCD 差异,线程迁移零惩罚,多线程扩展性更接近理论线性。
- AVX-512 全宽度 SIMD:单指令处理 512 位向量,配合翻倍前端带宽的 Zen 5 架构,在矩阵运算、FFT、编码器中被即时兑现为吞吐。
- TDP/PPT 冗余:270W 的插槽功耗上限意味着 32 线程满载时频率下垂更少,适合小时级连续计算任务。
五、UltraLAB 硬件配置怎么选
图 3:UltraLAB 基于 9950X3D2 的专业工作站整机方案200W TDP / 270W PPT 决定了这台机器的散热、供电、内存都不能含糊。以下按预算与负载给出三档示例配置(可根据具体项目定制):
| 部件 | 均衡创作档 | 专业生产力档 | 旗舰全能档 |
|---|---|---|---|
| CPU | AMD 锐龙 9 9950X3D2 Dual Edition(16C/32T,208MB) | ||
| 散热器 | 360mm 一体式水冷 | 420mm 一体式水冷 | 360mm 分体水冷 / 定制液冷 |
| 主板 | B850(8 层 PCB) | X870E | X870E 旗舰板(16+2+1 相供电) |
| 内存 | 64GB DDR5-6000 CL30(2×32GB)EXPO | 96GB DDR5-6000 CL30(2×48GB) | 128GB DDR5-6000 CL30(4×32GB,板厂 QVL 认证) |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | 4TB PCIe 5.0 NVMe SSD | 2×4TB PCIe 5.0 NVMe RAID 0 + 8TB 仓库盘 |
| 显卡 | RTX 5070 Ti 16GB | RTX 5080 16GB / RTX 5090 32GB | RTX 5090 32GB ×1~2(渲染/AI) |
| 电源 | 1000W 80Plus 金牌 ATX 3.1 | 1200W 白金 ATX 3.1 | 1600W 钛金 ATX 3.1 |
| 机箱 | 高风量中塔(前进后出直通风道) | 全塔(支持 420 冷排) | 全塔 / 机架式工作站 |
| 适用人群 | 视频剪辑、独立开发者、单机 AI 推理 | 编译密集型团队、3D 渲染、CAE 仿真 | 渲染农场节点、本地大模型、极限超频 |
选型要点:
- 散热是硬门槛:第三方实测显示 9950X3D2 满载温度可逼近 Tjmax 95°C,风冷难以驾驭,液冷不是可选项而是必选项。
- 内存认准 6000 CL30 甜点:JEDEC 5600 之上,DDR5-6000 可保持 FCLK/UCLK/MCLK 1:1,延迟最低;务必从主板 QVL 清单中选条并开启 EXPO。
- 主板供电 ≥12 相:270W PPT 持续输出要求 VRM 余量充足,X870E 为省心之选。
- GPU 按负载配:纯编译/仿真用户可用入门独显或核显点亮,把预算堆到内存与存储上。
六、软件清单
| 类别 | 软件 | 对 9950X3D2 的利用点 |
|---|---|---|
| 开发编译 | Visual Studio 2026、GCC、Clang、CMake、Ninja、LLVM | 32 线程并行编译 + 缓存驻留构建图 |
| 版本控制/CI | Git、Perforce、Jenkins、Docker / WSL2 | 容器镜像构建提速 |
| 3D 渲染 | Blender、V-Ray 7、Cinema 4D、Arnold、KeyShot | CPU 渲染稳定全核 + GPU 混合渲染 |
| 视频创作 | DaVinci Resolve 20、Premiere Pro、After Effects、Topaz Video AI | AVX-512 编解码 + GPU 加速特效 |
| 科学计算 | MATLAB、ANSYS、COMSOL、GROMACS、NAMD、OpenFOAM | AVX-512 SIMD + 大缓存仿真数据复用 |
| AI 工程 | PyTorch、TensorFlow、llama.cpp、Ollama、LM Studio、ONNX Runtime | CPU 推理缓存驻留 + 可选 CUDA/ROCm 混合 |
| 压缩工具 | 7-Zip、WinRAR、zstd | LZMA 字典驻留缓存,实测提升显著 |
| 系统调校 | AMD Ryzen Master、AMD Chipset Drivers、HWiNFO64、Cinebench 2026、7-Zip Benchmark | PBO / 曲线优化器调校与稳定性验证 |
七、常见问题:硬件配置分析
Q1:风冷能不能压 9950X3D2?为什么整机必须上水冷?
不能指望。默认 TDP 200W、PPT 270W,实测双烤功耗温度可逼近 95°C Tjmax,高端双塔风冷在短时负载下尚可,但编译/渲染动辄数小时的全核负载必然触发降频。UltraLAB 全系列 9950X3D2 工作站标配 360mm 起步液冷,正是为了保证持续性能释放。
Q2:我已经有 9950X3D,要不要升级双版本?
看你的负载。游戏玩家和轻办公用户不必升级——游戏时核心停驻机制只启用单个 CCD,双版本帧率与 9950X3D、9850X3D 基本持平。但如果你是每日全核满载的编译/渲染/仿真用户,双版本生产力负载约有 3%–9% 提升,且在 LZMA 压缩、GROMACS 分子动力学等缓存敏感任务上增益更高,按项目时薪折算,差价有机会回本。
Q3:内存上 8000 频率是不是更快?
不一定。9950X3D2 官方支持 JEDEC DDR5-5600,DDR5-6000 是频率与延迟的最佳平衡点(1:1 同频)。8000 频率需要异步分频,UCLK 减半反而推高延迟,且高频套条价格昂贵、对生产力收益有限。预算应优先给容量(64GB→96GB/128GB)而非频率。
Q4:四根内存插满会不会出问题?
Zen 5 双通道平台上 4×32GB 属于双面颗粒高密度配置,内存控制器压力增大,可能需要手动放宽时序或降频至 5600 运行。UltraLAB 建议在出厂前完成全容量 MemTest86 烧机验证,并以主板 QVL 清单为准选购。
Q5:旧 AM5 主板(X670E/B650)能直接用吗?
可以。9950X3D2 沿用 AM5 插槽,官方支持 A620/B650/X670/B850/X870 等芯片组。但老旧 BIOS 需先更新至包含 AGESA 1.2.0.x 及以上版本才能正确识别,且入门板的供电散热模组未必扛得住 270W 持续输出——老款主板用户请确认 BIOS 版本与 VRM 规格。
Q6:主板 BIOS 需要做哪些设置?
- 开启 EXPO(载入 DDR5-6000 CL30 预设);
- 散热条件允许时开启 PBO(Precision Boost Overdrive) 并配合曲线优化器(Curve Optimizer)负压调校;
- 装齐最新 AMD 芯片组驱动,确保双 CCD 调度策略生效;
- 建议关闭 Windows 的"内核隔离-内存完整性"以换取少量性能(视安全策略而定)。
Q7:这台机器配多大电源?
单卡配置建议 1000W 金牌起步;双 GPU 或 RTX 5090 旗舰卡建议 1200W–1600W 钛金/白金 ATX 3.1 电源,原生 12V-2×6 接口保障瞬时峰值安全。
八、总结
AMD 锐龙 9 9950X3D2 Dual Edition 不是一款"为所有人准备"的处理器,而是为缓存敏感型生产力负载交付确定性收益的专业工具:双 CCD 满配 3D V-Cache 从架构层面消除了调度不确定性,208MB 总缓存把桌面平台的内存墙向后推了一大步。在 UltraLAB 工作站体系中,只要配足液冷、DDR5-6000 甜点内存与稳健供电,它就是编译、渲染、仿真与本地 AI 推理场景下,AM5 平台无可争议的收官旗舰。
图 4:AMD 锐龙 9000 系列 X3D 产品矩阵参考来源
- AMD 官网:锐龙 9 9950X3D2 双缓存版规格页
- AMD 新闻稿:首款双路 3D V-Cache 台式机处理器发布
- 智东西:AMD Ryzen 9 9950X3D2 双版本处理器深度评测
- Chiphell / 超能网:9950X3D2 正式发售与规格对比
本文由 UltraLAB 技术评测组撰写,规格参数以 AMD 官方页面为准。文中配置为示例方案,UltraLAB 保留最终配置解释权。


