






核心结论:本地部署大模型,首先看显存容量,其次看显存带宽和 GPU 数量,再考虑 CPU、内存、NVMe 存储、网络及散热。32GB 适合轻量模型和开发验证,48GB 适合 32B 级模型与专业 AI 应用,80GB~96GB 适合 70B 级模型、高级微调及多用户推理,多卡平台面向更大规模模型和训练任务。
一、引言:当 AI 绘画工具撞上 Intel Arc 显卡
2026 年 9 月 23 日,B 站知名 AI 工具博主 秋叶 aaaki 发布了一条重磅视频——【AI绘画】Intel Arc 显卡版 ComfyUI 整合包发布!解压即用 一键启动 绘世启动器 秋叶整合包。视频上线后迅速获得 3.3 万播放、2670 点赞、1453 收藏和 320 次转发,评论区一片"秋叶大佬牛牛牛"的欢呼。
这条视频的核心信息看似简单:联合 Intel 完成了 ComfyUI Intel Arc 显卡的适配,发布整合包,解压即用,一键启动。但如果你深入思考,会发现这件事背后藏着一条重要的技术趋势线——AI 工具链正在从"仅限 NVIDIA 生态"走向"多 GPU 品牌兼容",而这一切的算力底座,恰恰是本文要讨论的核心:大模型本地部署,硬件到底该怎么选?
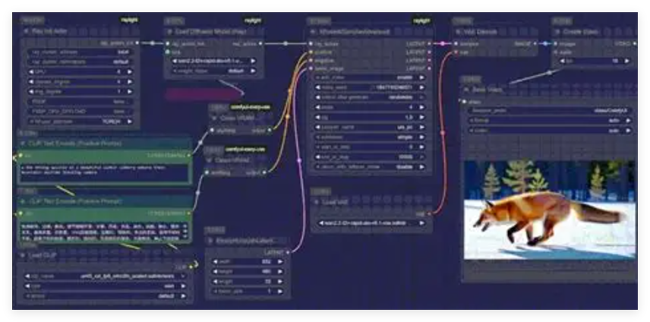
图 1:秋叶 aaaki 发布的 ComfyUI Intel Arc 整合包视频封面
二、AI 分析:视频核心内容解读
2.1 事件背景:ComfyUI 是什么?
ComfyUI 是一个基于节点式工作流的 AI 绘画工具,相比传统的 Stable Diffusion WebUI(Automatic1111),它具有以下核心优势:
- 节点式架构:将图像生成的每一步(文本编码、去噪、解码、后处理)拆分为独立节点,用户通过连线构建完整工作流
- 高度可定制:支持自定义节点扩展,可接入各种模型(SD 1.5、SDXL、SD3、Flux 等)
- 资源效率高:相比 WebUI 更节省显存,适合显存紧张的场景
- 批量处理能力:天然适合批量生成、参数扫描等自动化场景
2.2 Intel Arc 适配的技术意义
秋叶 aaaki 此次发布的整合包,核心价值在于降低了 Intel Arc 显卡用户使用 ComfyUI 的门槛:
| 整合包特性 | 技术价值 |
|---|---|
| 解压即用 | 免去复杂的环境配置,降低入门门槛 |
| 一键启动 | 封装启动脚本,自动检测硬件并优化参数 |
| 绘世启动器 | 提供图形化启动界面,支持多版本切换 |
| Intel Arc 适配 | 利用 Intel GPU 的 XeSS 超采样技术弥补算力差距 |
| 全中文界面 | 支持中文提示词,降低国内用户使用门槛 |
2.3 从"能用"到"好用":Intel Arc 的算力现实
Intel Arc 显卡(如 A770 16GB、A750 8GB)在 AI 推理领域的算力虽然不如同级别的 NVIDIA RTX 系列,但凭借 DirectML 和 DX12 推理后端,以及 Intel 不断优化的 oneAPI 生态,已经能够运行 Stable Diffusion 等主流 AI 绘画模型。对于预算有限的个人用户和爱好者来说,这是一条性价比极高的入门路径。
但需要注意的是,Intel Arc 在大规模模型训练和高分辨率图像生成方面仍有局限,这时就需要更强大的 GPU 算力支撑——而这正是 UltraLAB 硬件配置方案的价值所在。
三、核心算法与计算特点
3.1 Stable Diffusion 扩散模型原理
Stable Diffusion 是目前最主流的开源 AI 图像生成模型,其核心算法流程如下:
- 变分自编码器(VAE):将图像编码到潜空间(latent space),将 512x512 的 RGB 图像压缩为 64x64 的潜特征图,大幅降低计算复杂度
- U-Net 去噪网络:在潜空间中进行迭代去噪,从纯噪声逐步还原出目标图像。每一步去噪都需要调用文本编码器(CLIP)将提示词转为条件信号
- 文本编码器(CLIP/T5):将用户的自然语言提示词转化为模型可理解的向量表示
- VAE 解码:将去噪后的潜特征图解码回像素空间,输出最终图像
计算特点:
- 显存瓶颈:U-Net 网络在 SDXL 模式下需要约 6~8GB 显存,加上模型权重和 KV Cache,实际推理需要 8GB 以上显存
- 计算密集型:每一步去噪都需要大量的矩阵乘法运算,GPU 的 FP16/INT8 算力直接决定生成速度
- 显存带宽敏感:模型权重需要从显存读取到计算单元,显存带宽越高,token 生成速度越快
- 量化友好:扩散模型对精度损失不敏感,INT8/INT4 量化后视觉效果接近 FP16,但显存占用和算力需求大幅下降
3.2 ComfyUI 节点式工作流的计算特点
ComfyUI 的节点式架构带来了独特的计算特征:
| 计算特征 | 说明 | 硬件影响 |
|---|---|---|
| 模块化执行 | 每个节点独立执行,可并行调度 | 多核 CPU 加速节点调度 |
| 显存按需分配 | 未激活的节点不占用显存 | 总显存需求 = 最大单节点显存 + 模型权重 |
| 工作流缓存 | 相同输入可复用中间结果 | 大容量 NVMe SSD 加速模型加载 |
| 批量处理 | 多个提示词/参数可同时排队 | 大内存 + 大显存支持高并发 |
| 自定义节点 | 用户可编写 Python 节点扩展功能 | CPU 算力影响自定义节点执行速度 |
3.3 量化技术:FP16、INT8、INT4 怎么选?
量化是本地部署大模型的核心技术,直接影响显存占用和推理速度:
| 精度 | 特点 | 适用场景 |
|---|---|---|
| FP16 / BF16 | 精度高、显存占用大、适合科研验证 | 32B 级模型研究、70B 级多 GPU 部署、高质量模型评测 |
| INT8 | 显存约为 FP16 一半、性能/精度平衡好 | 企业生产环境、最大化并发场景 |
| INT4 (Q4_K_M) | 显存占用最低、单卡可运行更大模型 | 个人本地部署、32GB 显存运行大模型、性价比首选 |
选型口诀:小模型看算力,中大模型首先看显存,大模型训练看 GPU 数量和高速互联,企业 AI 平台还要看内存、NVMe、网络和软件栈。
四、UltraLAB 硬件配置怎么选:核心原则
4.1 选型黄金法则
大模型本地部署是 "GPU 显存密集 + 内存容量密集 + 存储 I/O 密集" 的三重叠加场景,选型遵循六条黄金法则:
- 显存容量决定模型规模:32GB 轻量与验证;48GB 适合 32B 模型与专业 AI 应用;80GB~96GB 适合 70B 模型、高级微调及多用户推理
- 显存带宽决定推理速度:同容量下 HBM3e > GDDR6X > GDDR6,带宽直接影响 token 生成速度
- CPU 负责数据预处理:Tokenizer、文档解析、RAG 检索、Embedding 依赖 CPU 多核,建议高频 16 核起步
- 内存容量决定并发能力:单用户 128GB 够用,企业知识库建议 256GB~512GB ECC,避免 Swap 导致性能暴跌
- NVMe SSD 是刚需:模型文件几十至数百 GB,NVMe Gen5 SSD(14GB/s)可将加载与读取时间缩短 50% 以上
- 散热决定稳定性:GPU 持续满载与游戏瞬时负载完全不同,7x24 小时运行必须配备工业级水冷或分体式散热
4.2 GPU 选型决策矩阵
| GPU 平台 | 显存 | 推荐定位 | 典型应用 |
|---|---|---|---|
| RTX 5090 水冷 | 32 GB | 高性能个人 AI | LLM 推理、AI 编程、RAG 验证 |
| RTX 4090 48GB 水冷定制版 | 48 GB | 大显存 AI 工作站 | 32B 模型、70B 量化、LoRA 微调 |
| RTX PRO 5000 | 48 GB | 专业 AI 工作站 | 企业 AI、科研、RAG、QLoRA |
| A100 80GB 水冷定制版 | 80 GB | 高端 AI 计算 | 70B 推理、全参数微调、训练 |
| RTX PRO 6000D | 84 GB | 专业 AI 推理/科研 | 70B 级模型、Agent、多模态 |
| RTX PRO 6000 | 96 GB | 旗舰 AI 工作站 | 70B 级模型、微调、多用户并发 |
消费级 vs 专业级:个人开发者、AI 编程和预算敏感用户可选 RTX 5090;高校、科研院所和企业采购建议优先考虑 RTX PRO 系列——专业 GPU 平台具备 ECC 纠错与更稳定的驱动支持,更适合长期运行。
4.3 四级配置方案推荐
方案 A:AI 开发者工作站(预算 2~4 万)
适合:个人开发、AI 编程、7B~32B 量化模型、RAG 验证。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 265K(20核,最高睿频5.5GHz) | 高频多核,加速数据预处理 |
| GPU | RTX 5090 32G + 水冷 | 消费级旗舰,性价比最高 |
| 内存 | 64GB DDR5 | 满足单用户开发需求 |
| 存储 | 4TB NVMe + 8TB SATA | 模型文件+数据集双盘方案 |
| 机箱/电源 | 塔式(2000W) | 保障持续满载稳定运行 |
| 参考价格 | 约 ¥42,000~¥62,000 | UltraLAB A350 系列 |
方案 B:专业 AI 科研工作站(预算 5~8 万)
适合:高校、科研院所、企业研发部门、32B 模型推理、LoRA 微调。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 265K(20核,最高睿频5.5GHz) | 高频多核,平衡算力与功耗 |
| GPU | RTX Pro 5000 48G | 专业卡,ECC纠错,7x24稳定 |
| 内存 | 96GB DDR5 | 支持多任务并行 |
| 存储 | 4TB NVMe + 8TB SATA | 大容量模型仓库 |
| 机箱/电源 | 塔式(2000W) | 工业级散热方案 |
| 参考价格 | 约 ¥79,000~¥93,500 | UltraLAB A350 系列 |
方案 C:AI 超级工作站(预算 9~15 万)
适合:70B 级模型本地部署、多模态 AI、高级 QLoRA 微调、科研 AI 平台。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 270K Plus(24核,最高睿频5.5GHz) | 更多核心,加速批量推理 |
| GPU | RTX Pro 5000 72G 或 A100 80G | 大显存支撑70B级模型 |
| 内存 | 192GB DDR5 | 企业级知识库高并发 |
| 存储 | 4TB NVMe + 8TB SATA | 海量模型与数据集 |
| 机箱/电源 | 塔式(2200W) | 高端散热保障 |
| 参考价格 | 约 ¥132,000~¥149,000 | UltraLAB A350 系列 |
方案 D:多 GPU 大模型训练服务器(预算 20~80 万+)
适合:企业 AI 平台、科研集群、大模型全参数训练、多用户推理。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | AMD 霄龙 7763(64核 2.45~3.5GHz) | 服务器级多核,分布式训练 |
| GPU | 2~8x RTX 4090 48G / Pro 6000 96G / H20 140G | 多卡并行,显存池化 |
| 内存 | 256GB~768GB DDR4 | 超大规模数据集+多模型并发 |
| 存储 | 8TB NVMe + 8TB SATA(多盘位) | 高速模型加载+海量存储 |
| 机箱/电源 | 双塔式(2x2000W) / 机架式 | 企业级可靠性 |
| 参考价格 | 约 ¥212,000~¥1,100,000 | UltraLAB AE430/GA650M/GA658 系列 |
五、软件清单:从裸机到可生产的 AI 工具链
5.1 大模型本地部署核心软件栈
| 分类 | 工具/框架 | 核心用途 | 硬件要求 |
|---|---|---|---|
| 操作系统 | Ubuntu 24.04 LTS(首选)/ Windows 11 Pro | 系统基础环境 | 通用 |
| Python 环境 | conda 隔离 + Python 3.10~3.12 | 依赖管理与环境隔离 | 通用 |
| 容器化 | Docker + NVIDIA Container Toolkit | 模型环境隔离与复现 | 通用 |
| GPU 驱动 | NVIDIA Studio/数据中心驱动 | AI 计算稳定性 | NVIDIA GPU |
| AI 推理框架 | vLLM / Text Generation Inference | 大模型高效推理服务 | 大显存 GPU |
| 模型加载器 | llama.cpp / Ollama / LM Studio | 本地模型运行 | 通用(支持多GPU) |
| AI 绘画工具 | ComfyUI / Stable Diffusion WebUI | AI 图像生成 | GPU 显存>=8GB |
| 向量数据库 | Chroma / Milvus / Faiss | RAG 知识库检索 | 大内存 |
| 开发工具 | Jupyter Notebook / VS Code | 模型开发与调试 | 通用 |
5.2 部署环境建议
- 操作系统:Ubuntu 24.04 LTS(首选,驱动兼容性最佳)/ Windows 11 Pro(兼容性好,适合个人用户)
- Python 环境:conda 隔离 + Python 3.10~3.12,避免依赖冲突
- 容器化:Docker + NVIDIA Container Toolkit,便于模型环境隔离与复现
- 驱动:NVIDIA Studio/数据中心驱动(AI 计算更稳定),Intel Arc 用户需安装最新 Arc 驱动 + DirectML 运行时
六、应用场景:谁需要本地部署大模型?
| 应用场景 | 主要需求 | 推荐显存 | 代表模型 |
|---|---|---|---|
| AI 聊天/个人助手 | 7B~14B 模型、量化推理、日常问答 | 32 GB | Qwen2.5-7B、Llama 3.1-8B |
| 企业知识库/RAG | 14B~32B 模型、Embedding、向量数据库 | 32 GB ~ 48 GB | DeepSeek-R1-14B、Qwen2.5-32B |
| AI Agent 智能体 | 长上下文、工具调用、多模型协同 | 48 GB ~ 96 GB | DeepSeek-V3.x、Qwen2.5-72B |
| AI 编程助手 | Code 模型、长上下文、代码补全 | 32 GB ~ 96 GB | Qwen2.5-Coder-32B、DeepSeek-Coder |
| 科研 AI 助手 | 文献分析、数学推理、实验记录分析 | 48 GB ~ 96 GB | Qwen2.5-72B、Llama 3.1-70B |
| 多模态 AI | 图像理解、文档 OCR、视频分析 | 48 GB ~ 96 GB | Qwen2.5-VL、Llama 3.2-Vision |
| LoRA/QLoRA 微调 | 7B~70B 级模型低秩适配 | 48 GB ~ 96 GB 及多卡 | DeepSeek、Qwen 全系列 |
| 全参数训练 | 大模型预训练/持续训练 | 多 GPU 服务器(4~8 卡) | DeepSeek、Qwen3 |
回到秋叶视频的场景:无论是用 ComfyUI 本地生成 AI 绘画作品、让 AI Agent 批量跑工作流、还是给企业提供私有知识库问答,共同点都是长时间、多轮次、数据敏感的本地计算——云端 API 的按次计费、数据出域和速率限制都不合适,本地部署是唯一解。
七、大模型本地部署核心逻辑
7.1 为什么显存是第一生产力?
大模型部署首先要解决的是模型权重能否装入 GPU 显存。粗略估算:
| 模型规模 | FP16/BF16 权重 | INT8 权重 | INT4 权重 | 推荐显存平台 |
|---|---|---|---|---|
| 7B | approx 14 GB | approx 7 GB | approx 4 GB | 16 GB ~ 32 GB |
| 14B | approx 28 GB | approx 14 GB | approx 7 GB | 32 GB |
| 32B | approx 64 GB | approx 32 GB | approx 16 GB | 48 GB ~ 96 GB |
| 70B | approx 140 GB | approx 70 GB | approx 35 GB | 80 GB ~ 96 GB 或多卡 |
| 100B+ | approx 200 GB+ | approx 100 GB+ | approx 50 GB+ | 多 GPU 服务器 |
关键提示:量化后"权重能装下"不等于"能高性能运行"。长上下文、高并发会显著增加 KV Cache 及运行时显存。建议 48GB 为当前甜点配置,96GB 为未来 3 年储备。
7.2 部署环境最佳实践
- 操作系统优先选 Ubuntu 24.04 LTS:NVIDIA 驱动和 CUDA 工具链兼容性最佳,Intel Arc 用户也可获得较好的 oneAPI 支持
- Python 环境用 conda 隔离:不同项目依赖不同版本的 PyTorch、Transformers 等库,conda 环境隔离可避免冲突
- 容器化部署:Docker + NVIDIA Container Toolkit 实现模型环境的隔离与复现,方便在生产环境中统一部署
- 驱动选择:AI 计算场景优先选择 NVIDIA Studio 驱动或数据中心驱动,稳定性优于 Game Ready 驱动
八、常见问题硬件配置分析(FAQ)
Q1:32GB 显存能不能部署大模型?
可以。 32GB 适合 7B~14B FP16 模型,以及更大规模模型的 INT4 量化部署。AI 编程、RAG 和个人助手场景,RTX 5090 32GB 属于高性价比方案,实测 Qwen2.5-14B(Q4_K_M)可达 75 token/s。
Q2:48GB 和 32GB 应该怎么选?
预算允许,优先 48GB。32GB 主要受容量限制;48GB 可支持 32B FP16 或 70B INT4,并为 KV Cache 与长上下文留出空间,是企业知识库和 Agent 场景的甜点配置。
Q3:70B 模型需要多大显存?
- FP16 权重约 140GB:建议 2x80GB/96GB(NVLink)多卡全精度推理
- INT8 约 70GB:80GB 单卡适合及部分优化部署
- INT4 约 35GB:48GB 级 GPU 具备较好的部署条件
注意:96GB 单卡也不等于"完整跑 70B FP16",需结合量化或 offload 技术。
Q4:为什么 128GB 内存已经不够用了?
10 万份文档的企业知识库,Embedding 向量 + 索引可占 50GB+;加上推理 KV Cache 和系统缓存,128GB 很容易触顶。内存不足触发 Swap 后,推理速度暴跌 10 倍以上。企业级建议 256GB 起步,大型平台 512GB。
Q5:NVMe Gen5 SSD 真的有必要吗?
绝对有必要。 大模型文件通常几十至数百 GB(部分 MoE 模型权重超 160GB)。SATA(500MB/s)加载需 5 分钟以上,NVMe Gen5(14GB/s)仅需约 10 秒。频繁切换模型、批量任务队列和训练场景,Gen5 能彻底消除 I/O 瓶颈。
Q6:大模型本地部署 CPU 重要吗?
重要,但优先级低于 GPU 显存。 CPU 负责 Tokenizer、文档解析、RAG 检索、Embedding 与多用户服务。部署 AI 知识库建议高频 16 核 + 128GB 内存起步,大型企业知识库建议 32 核 + 256GB~512GB。
Q7:本地部署 DeepSeek / Qwen 应该买什么配置?
| 模型规模 | 推荐 GPU | 适用场景 |
|---|---|---|
| 7B~14B | RTX 5090 32GB | 个人助手、代码补全、轻量 RAG |
| 32B | RTX PRO 5000 48GB | 企业知识库、复杂推理、AI Agent |
| 70B 量化 | 48GB~96GB | 长上下文对话、高质量问答 |
| 70B FP16/BF16 | 2x80GB/96GB 级 GPU | 科研验证、高精度推理、模型评测 |
| 100B+ | 多 GPU 服务器 | 企业 AI 平台、多用户服务 |
| 数百 B 级 MoE | 4~8 GPU 服务器 | 大模型训练、国家级课题 |
Q8:Intel Arc 显卡适合做 AI 本地部署吗?
Intel Arc 显卡(如 A770 16GB)可以通过 DirectML 后端运行 ComfyUI 和 Stable Diffusion,适合轻度 AI 绘画和实验性学习。但对于生产级的大模型推理或训练,建议优先选择 NVIDIA RTX 系列或专业级 GPU(如 RTX PRO 系列、A100、H100),以获得更好的性能支持和生态兼容性。UltraLAB 提供的 Intel 平台工作站也支持 Intel GPU 的混合计算方案。
九、总结与选型结论
9.1 选型路线一张图
32GB  →  AI开发 / 7B~14B / RAG / AI编程
  ↓
48GB  →  32B模型 / 企业知识库 / Agent / QLoRA
  ↓
80GB~96GB  →  70B级模型 / 多模态 / 高级微调 / 多用户
  ↓
4~8 GPU  →  大模型训练 / 企业AI平台 / 大规模推理
9.2 结论
- 多数高校、科研院所和企业研发用户:首选 RTX PRO 5000 48GB 和 RTX PRO 6000 96GB
- 个人开发者和预算敏感用户:首选 RTX 5090 32GB 水冷工作站,或尝试 Intel Arc 显卡入门
- 大模型训练和多用户 AI 平台:选择 4~8 GPU 级 UltraLAB AI 服务器,并配置高速网络和分布式训练软件
选型理念:采购前明确以下信息——模型名称及参数规模、精度(FP16/INT8/INT4)、上下文长度与并发数、是否需要 LoRA/QLoRA 或全参数训练、是否需要多模态与 RAG、是否需要多 GPU 分布式训练。UltraLAB 可据此对 CPU、GPU、内存、NVMe、网络、电源及散热进行定制化设计,实现"算法匹配优先于配置堆砌"。
9.3 写在最后
Intel Arc 显卡版 ComfyUI 整合包的发布,标志着 AI 工具链正在打破 GPU 品牌壁垒,让更多用户能够以更低成本接入 AI 绘画和 AI 创作的世界。但如果你需要的不仅是"能用",而是"好用"——稳定的 7x24 小时推理、百 B 级模型的本地部署、企业级知识库的高并发服务——那么一台精心配置的 UltraLAB 工作站或服务器,才是你真正的 AI 算力底座。
大模型本地部署,正是这场变革的算力地基:数据不出内网、7x24 小时待命、Agent 工具链随取随用。选择一台合适的 UltraLAB 工作站,不是买一块显卡,而是为接下来三到五年的 AI 工作流,打下一台不会掉链子的本地算力底座。
关于 UltraLAB:西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注于 AI 大模型、科学计算、工程仿真等领域的异构超算解决方案。业务咨询:400-705-6800。
本文参考来源:秋叶aaaki B站视频《【AI绘画】Intel Arc显卡版 ComfyUI 整合包发布!解压即用 一键启动 绘世启动器 秋葉整合包》(https://www.bilibili.com/video/BV1x7h46eEqY/)、UltraLAB 2026v3 深度学习基准配置方案。


