






摘要:ZeRO(Zero Redundancy Optimizer)是 DeepSpeed 的核心显存优化技术,通过将优化器状态、梯度和模型参数在数据并行进程间分片,显著降低单卡显存占用,使有限规模的 GPU 也能训练数十亿参数模型。本文面向需要在本地工作站开展大模型预训练、微调的科研人员与算法工程师,分析 ZeRO 各阶段的计算与通信特征,并给出 UltraLAB 图形工作站的分档硬件选型建议。
适用读者:人工智能实验室研究人员、大模型微调工程师、高校科研团队 IT 采购人员。
资料背景与核心观点
- 资料名称:ZeRO: Memory Optimizations Toward Training Trillion Parameter Models(SC '20 论文,arXiv:1910.02054),以及 DeepSpeed 官方 ZeRO 教程与开源仓库。
- 发布机构:Microsoft Research / DeepSpeed 团队。
- 原文链接:https://arxiv.org/abs/1910.02054、https://www.deepspeed.ai/tutorials/zero/、https://github.com/deepspeedai/DeepSpeed
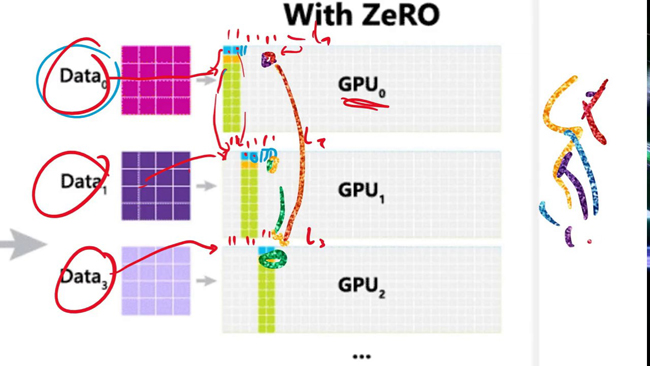
论文的核心观点是:传统数据并行(DDP)在每个 GPU 进程上完整复制优化器状态、梯度和参数,存在严重显存冗余。ZeRO-DP 将这三类"模型状态"按进程分片(Stage 1 优化器状态、Stage 2 加梯度、Stage 3 加参数),在几乎不增加通信量(Stage 1/2)或通信量约为 1.5 倍(Stage 3)的代价下,把单卡显存占用压缩到原来的 1/N_d(N_d 为数据并行度)。论文报告在 400 块 V100 GPU 上训练超过 100B 参数模型,并可在无模型并行的情况下训练 13B 参数模型。配套的 ZeRO-Offload(USENIX ATC 2021,arXiv:2101.06840)进一步把优化器状态与梯度卸载到 CPU 内存甚至 NVMe,使单卡即可开展十亿级模型训练。
主要功能模块与核心算法
- ZeRO-DP 三阶段分片:Pos(优化器状态分片)、Pos+g(梯度分片,用 Reduce-Scatter 替代 All-Reduce)、Pos+g+p(参数分片,前向/反向时按需 All-Gather)。
- ZeRO-R 残余显存优化:激活检查点划分(Partitioned Activation Checkpointing)、固定大小显存缓冲区、显存碎片整理(Memory Defragmentation)。
- ZeRO-Offload / ZeRO-Infinity:将优化器状态与梯度卸载至 CPU 内存,必要时进一步卸载至 NVMe SSD,配合 CPU 端 Adam 计算。
- 通信结构:Stage 1/2 总通信量与标准数据并行相同(2Ψ);Stage 3 为 3Ψ,对多卡互联带宽更敏感。
- 混合精度训练:默认配合 FP16/BF16 混合精度与损失缩放使用,降低显存并提升张量核利用率。
计算特点与性能瓶颈
- 计算/显存双密集:Transformer 训练是典型 GPU 计算密集型负载(GEMM 为主),但可训模型规模首先受单卡显存容量约束,其次才是算力。以 Adam 优化器、混合精度估算,每 10 亿参数约需 16GB 显存(参数 2GB + 梯度 2GB + 优化器状态 8GB + FP32 主权重 4GB,未计激活值)。
- 并行方式:单机内以 NVLink/PCIe 互联的多卡数据并行为主;ZeRO Stage 3 与 Offload 对 CPU 内存容量和 GPU—CPU 间 PCIe 带宽提出较高要求。
- CPU 角色:常规 ZeRO 下 CPU 负载较轻;启用 ZeRO-Offload 后 CPU 承担优化器更新,需要较高的核心数与内存带宽,CPU 内存通常建议为 GPU 显存总量的 1.5—2 倍以上。
- I/O 与存储:训练数据加载、检查点写入(大模型单次 checkpoint 可达数十至上百 GB)要求 NVMe SSD 提供高顺序读写与足够容量;ZeRO-Infinity 的 NVMe 卸载模式对 SSD 随机读写性能尤为敏感。
- 瓶颈排序:显存容量 → GPU 互联带宽 → 数据管线 I/O → CPU 单核性能(数据预处理阶段)。
典型应用场景
- 场景一:7B—13B 级模型全参数微调。单机 2—4 块大显存 GPU,ZeRO Stage 2 + 混合精度,批量语料数十至数百 GB,属科研工作站最常见负载。
- 场景二:13B—70B 级模型领域适配。4—8 卡 + ZeRO Stage 3 或 ZeRO-Offload,需要大内存与高速 PCIe 拓扑支撑。
- 场景三:小规模预训练与教学科研。单卡 + ZeRO-Offload 在 24—48GB 显存上开展 1B—7B 级模型训练验证,成本低、迭代快。
- 典型工作流:数据清洗与分词(CPU 密集)→ 分布式训练(GPU 密集)→ 检查点评估与导出(I/O 密集),三个阶段对硬件的需求差异明显,适合"一机多角色"的工作站形态。
UltraLAB 硬件配置建议
说明:以下档位按 UltraLAB 图形工作站产品线的典型形态描述配置思路,具体型号、价格与可订配置请以 UltraLAB 官方确认为准。GPU 加速与框架兼容性以所用 DeepSpeed/PyTorch/CUDA 版本组合为准,采购前建议核实软件栈支持矩阵。
| 配置项 | 入门档:单卡微调与教学 | 主流档:双卡/四卡训练工作站 | 高性能档:四至八卡大显存平台 |
|---|---|---|---|
| CPU 选型思路 | 高主频 12—16 核(如 Intel Core i9 / AMD Ryzen 9 级),保证数据预处理吞吐 | 24—32 核单路工作站级 CPU(如 Xeon W / Threadripper PRO 级),兼顾多卡数据加载 | 32—64 核高内存带宽平台(如 Threadripper PRO / 双路至强级),为 Offload 与多卡数据管线留裕量 |
| 内存 | 64—128GB DDR5 | 256GB ECC(约为显存总量 1.5 倍以上) | 512GB—1TB ECC,支撑 ZeRO-Offload 与多任务并行 |
| GPU 与显存 | 1× 24—32GB 显存消费/专业卡(如 RTX 4090/5090 级;需要 ECC 与虚拟化时选 RTX A 系列/RTX PRO 级) | 2—4× 48GB 级专业卡(如 RTX A6000 / L40S / RTX 6000 Ada 级),NVLink 或高带宽 PCIe 拓扑 | 4—8× 48—96GB 大显存卡(如 RTX 6000 Ada / RTX PRO 6000 级),优先 NVLink 互联机型 |
| 系统盘 / 项目盘 / 数据盘 | 1TB NVMe 系统盘 + 2TB NVMe 项目盘 | 1TB NVMe 系统盘 + 2×2TB NVMe 项目/缓存盘 + 8TB 以上 SATA/NAS 数据盘 | 2TB NVMe 系统盘 + 4TB 以上 NVMe 高速 scratch(供 ZeRO-Infinity 卸载与检查点)+ 大容量数据阵列 |
| 散热 / 电源 / 扩展性 / 稳定性 | 塔式静音风冷,1000W 级电源,预留第二条 PCIe x16 空间 | 多卡风道优化机箱或 4U 机架形态,1600—2200W 冗余电源,PCIe 槽位与供电预留 | 机架式、强制风冷/液冷可选,双路冗余电源,支持未来扩展至 8 卡与更大内存 |
| 适用场景 | 1B—7B 模型微调、算法验证、教学 | 7B—13B 全参数微调、多任务并行训练 | 13B—70B 领域适配、小集群前哨节点 |
推荐理由与升级方向:入门档优先把预算投向单卡显存容量;主流档的核心矛盾是多卡互联带宽与显存总量,建议选择 PCIe 通道充足、支持 GPU 直通的单路平台;高性能档应同步规划 CPU 内存(Offload 依赖)与 NVMe scratch 容量,并为后续向服务器/集群形态迁移保留机架与供电条件。
软件清单
| 类别 | 软件/组件 | 必需性 | 说明 |
|---|---|---|---|
| 训练框架 | PyTorch(匹配 CUDA 版本) | 必需 | ZeRO 依赖 PyTorch 生态 |
| 显存优化库 | DeepSpeed | 必需 | ZeRO Stage 1/2/3、Offload、Infinity |
| 分布式运行时 | NCCL | 必需 | 多卡通信后端 |
| 模型生态 | Hugging Face Transformers / Accelerate / TRL | 可选 | 与 DeepSpeed 集成的微调栈 |
| 运行环境 | CUDA Toolkit、NVIDIA 驱动、conda/容器(Docker/Apptainer) | 必需 | 版本组合需与 DeepSpeed 匹配 |
| 编程与调试 | Python、VS Code/PyCharm、Nsight Systems | 可选 | 性能剖析定位通信/数据管线瓶颈 |
| 监控可视化 | Weights & Biases / TensorBoard、nvitop | 可选 | 训练曲线与显存监控 |
常见问题(FAQ)
Q1:单卡 24GB 显存能微调多大的模型?
配合 ZeRO-Offload 与 LoRA 类参数高效方法,24GB 显存通常可完成 7B 级模型的指令微调;全参数微调 7B 模型一般需要 48GB 以上单卡显存或多卡 ZeRO Stage 3。具体上限与序列长度、批量大小强相关,建议先用官方示例实测。
Q2:多卡训练选消费卡还是专业卡?
消费级卡算力性价比高,但缺少 ECC 显存、长时间满载稳定性与厂商质保定位不同,且部分机型不支持多卡堆叠与 NVLink。面向 7×24 小时科研生产,建议选择专业可视化/计算卡;消费卡适合预算敏感的算法验证场景,但需接受相应的稳定性折中。
Q3:ZeRO-Offload 会把瓶颈转移到 CPU 吗?
会。Offload 模式下优化器更新在 CPU 上执行,CPU 核心数、内存容量与内存带宽都会直接影响 step 时间。规划此类配置时,CPU 不宜低于 16 核,内存建议为显存卸载量的 1.5 倍以上。
Q4:NVMe SSD 对训练速度影响大吗?
数据管线充分预取时影响有限;但大模型检查点写入与 ZeRO-Infinity 的 NVMe 卸载对 SSD 持续读写非常敏感。涉及 Infinity 卸载时应选择高耐久、高顺序写性能的企业级 NVMe,并预留数倍于单次检查点大小的空间。
Q5:什么时候应该从工作站升级到服务器/集群?
当模型规模超过单机 8 卡显存与分片能力、或单任务排队时间超过可接受周期时,工作站的边际收益下降。此时建议以"工作站做开发与中小规模实验 + 集群做大规模训练"的组合方式规划预算。
总结与选型建议
ZeRO 的价值在于把"显存墙"转化为"容量规划问题":先根据目标模型参数量与训练方式(全参数/LoRA、Stage 2/3、是否 Offload)估算显存与内存需求,再倒推 GPU 数量、单卡显存与 CPU 内存配比,最后检查 NVMe 与供电散热是否匹配。UltraLAB 图形工作站可覆盖从单卡微调到八卡大显存平台的完整梯度;建议科研用户以"当前最大模型 + 一档余量"为原则选型,避免为尚未发生的超大规模训练过度投资。涉及具体 DeepSpeed/CUDA 版本兼容性与多卡拓扑时,请以官方文档和实际测试结果为准。
参考来源
- Rajbhandari S. 等. ZeRO: Memory Optimizations Toward Training Trillion Parameter Models. arXiv:1910.02054. https://arxiv.org/abs/1910.02054
- DeepSpeed 官方教程:Zero Redundancy Optimizer. https://www.deepspeed.ai/tutorials/zero/
- DeepSpeed GitHub 仓库. https://github.com/deepspeedai/DeepSpeed
上述所有配置,代表最新硬件架构,同时保证是最完美,最快,如有不符,可直接退货
欲咨询机器处理速度如何、技术咨询、索取详细技术方案,提供远程测试,请联系
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800



