






——高维小样本场景的"开箱即用"利器,硬件配置如何匹配算法特性?
一、算法核心:为什么随机森林"好用"却"吃"算力?
随机森林(Random Forest)是机器学习领域使用最广泛的集成算法之一。它的核心思想极其朴素:一棵树容易过拟合,那就种一片森林,投票取多数。但在这份"朴素"背后,是对计算资源的隐性需求——尤其是当数据维度飙升到万级、树的数量堆到千级时,"跑个RF"可能从"秒级"变成"小时级"。
本文将从计算特点、软件工具、应用场景、硬件配置四个维度,拆解随机森林算法的"算力密码",帮助科研团队和数据科学家选择与之匹配的计算装备。
二、随机森林的核心计算特点
特点一:双重随机性 = 海量独立计算
随机森林的"随机"体现在两个层面,缺一不可:
表格
| 随机维度 | 机制 | 计算影响 |
|---|---|---|
| 样本随机(Bootstrap) | 每棵树有放回抽样63.2%样本训练,36.8%为OOB验证集 | 每棵树独立训练,无法串行复用中间结果 |
| 特征随机(mtry) | 每个节点分裂时随机选√p个特征(分类)或p/3个特征(回归) | 特征子集搜索增加计算量,但降低树间相关性 |
关键结论: 双重随机性保证了Bagging的方差缩减效果(Var_avg = ρ·σ² + (1-ρ)·σ²/B),但代价是每棵树必须独立从头训练,无法像Boosting那样利用前一棵树的残差。这意味着RF的并行度天然是100%——有多少核,就能并行训练多少棵树。
特点二:OOB估计 = 零成本交叉验证
随机森林的Out-of-Bag(OOB)误差估计是其独特优势:每个样本约有36.8%的树没见过它,用这些树投票预测即可得到该样本的OOB预测。Breiman证明,OOB误差几乎等价于5折交叉验证,但无需重复训练模型。
计算影响: OOB估计在训练过程中同步完成,不增加额外计算成本。但若要绘制OOB error vs n_estimators曲线以确定最优树数量,需要完整训练多轮不同n_estimators的模型,总计算量与最大n_estimators成正比。
特点三:特征重要性计算 = 双重开销
RF提供两种特征重要性度量:
表格
| 方法 | 计算方式 | 开销 |
|---|---|---|
| Gini Importance(MDI) | 统计每棵树中某特征分裂带来的Gini不纯度减少量 | 训练时同步计算,几乎零额外开销 |
| Permutation Importance(MDA) | 打乱某特征值后重新计算OOB误差增量 | 需对每棵树、每个特征重复预测,计算量 = n_estimators × n_features × n_samples |
关键结论: Permutation Importance更可靠但计算昂贵。对于万级特征(如基因表达数据),MDA的计算量可能超过训练本身。
特点四:树的数量"收敛"而非"越多越好"
RF的方差缩减公式:
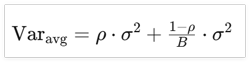
当树的数量B增大时,第二项趋近于0,但受限于树间相关性ρ,方差不会降到0。实际应用中,OOB error通常在100-500棵树时收敛,继续增加只会浪费算力。
计算影响: 盲目设n_estimators=1000甚至2000是常见误区。建议先以较小值(如100)训练,绘制OOB曲线确定收敛点,再精调。这要求硬件支持快速迭代实验。
特点五:高维小样本 = 内存瓶颈
RF的典型应用场景(基因表达、代谢组学)具有高维(p=10,000~50,000)、小样本(n=100~1000)特征。虽然RF不需要标准化,但:
-
每棵树的Bootstrap样本矩阵大小为 n × p
-
万级特征 × 千级样本 = 单棵树内存占用达 数百MB
-
并行训练多棵树时,内存需求线性增长
关键结论: 对于高维数据,RF的内存需求远超低维场景,大容量内存是刚需。
三、软件工具:从sklearn到分布式框架
工具一:scikit-learn(Python首选)
Python
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier( n_estimators=200, # 树的数量 max_depth=20, # 最大深度 max_features='sqrt', # 特征随机数:√p oob_score=True, # 启用OOB估计 n_jobs=-1, # 使用全部CPU核心 random_state=42 ) rf.fit(X_train, y_train)
优势: API简洁,生态成熟,与NumPy/SciPy/Pandas无缝集成,OOB估计和特征重要性内置。
局限: 单节点多线程并行,不支持分布式集群;高维数据(p>10,000)时训练速度明显下降。
工具二:XGBoost / LightGBM(梯度Boosting备选)
虽然XGBoost和LightGBM属于Boosting而非Bagging,但在实际应用中常与RF对比:
表格
| 对比维度 | 随机森林(RF) | XGBoost |
|---|---|---|
| 并行方式 | 树间完全并行 | 树间串行,特征并行/直方图并行 |
| 加树效果 | 只降方差,不会过拟合 | 降偏差,可能过拟合 |
| 高维小样本 | 更稳,自带特征选择 | 需配合early stopping |
| 计算速度 | 树多但并行度高 | 树少但每棵树计算复杂 |
选型建议: 高维小样本(基因表达、代谢组学)优先RF;大规模表格数据(千万级样本)优先XGBoost/LightGBM。
工具三:Spark MLlib(分布式大数据)
Python
from pyspark.ml.classification import RandomForestClassifier

rf = RandomForestClassifier( numTrees=200, maxDepth=20, featureSubsetStrategy="sqrt" ) model = rf.fit(train_df)
优势: 支持分布式集群,可处理TB级数据。
局限: 功能不如sklearn丰富(如不支持OOB估计),调参灵活性差,适合数据量大但特征维度不高的场景。
工具四:R randomForest / ranger
R包randomForest: 经典实现,生态成熟,与R的统计可视化工具链集成好。
R包ranger: 纯C++实现,号称" fastest implementation of random forests in R or Python ",支持C++级多线程和内存优化,高维数据性能显著优于sklearn。
r
library(ranger) model <- ranger( dependent.variable.name = "y", data = train_data, num.trees = 200, mtry = sqrt(ncol(train_data)-1), importance = "permutation" )工具五:H2O.ai(企业级AutoML)
优势: 支持分布式集群,内置AutoML自动调参,支持GPU加速(部分操作)。
适用场景: 企业级大规模机器学习流水线,需与现有大数据平台集成。
四、应用场景:RF的"舒适区"与"禁区"
场景一:生物信息学 — 基因表达分类与Marker筛选(★★★★★)
典型任务: 用20,000个基因表达量预测癌症亚型,样本量仅100-500。
RF优势:
-
不需要标准化(树模型对特征尺度不敏感)
-
自带特征重要性,可直接筛选Top Marker基因
-
高维小样本下比SVM/LR更稳,不易过拟合
推荐工作流: RF粗筛(Top 50基因)→ 下游可视化(热图、PCA)→ SVM/LR精排
场景二:金融风控 — 信用评分与欺诈检测(★★★★)
典型任务: 用数百个特征预测贷款违约概率。
RF优势: 处理混合类型数据(数值+类别)能力强,特征重要性辅助业务解释,对缺失值不敏感。
注意: 类别不平衡时需设置
class_weight='balanced'。
场景三:遥感影像 — 土地利用分类(★★★★)
典型任务: 用多光谱/高光谱波段及纹理特征进行像素级分类。
RF优势: 多分类天然支持,对高维特征空间适应性好,训练速度快于SVM。
场景四:推荐系统 — 特征工程与粗排(★★★)
典型任务: 用户-商品交互特征的高维稀疏矩阵。
局限: 高维稀疏数据(如One-Hot编码后百万维)时,RF效率不如线性模型或深度学习。更适合作为特征重要性分析工具,辅助特征选择。
场景五:时序预测 — 金融/能源预测(★★★)
典型任务: 用历史特征预测股票价格或电力负荷。
局限: RF不擅长捕捉时序依赖关系,需手动构造滞后特征。长序列时序预测建议用LSTM/Transformer。
五、硬件配置推荐:让RF"跑满"的装备方案
基于RF的计算特点,我们针对不同数据规模和场景推荐以下配置:
方案A:个人科研工作站(高维小样本,万级特征)
适用场景: 基因表达、代谢组学、蛋白质组学,特征10,000-50,000,样本100-2,000
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Ryzen 9 7950X (16核32线程) / Intel Core i9-14900K | 高主频+多核,树间并行训练效率高 |
| 内存 | 128GB DDR5-5600 | 万级特征 × 千级样本 × 200棵树 ≈ 数十GB驻留内存 |
| 存储 | 2TB NVMe SSD | 快速加载大型表达矩阵(.h5/.csv) |
| 显卡 | 可选:NVIDIA RTX 4060 Ti 16GB | RF不刚需GPU,但后续深度学习(如用RF筛选后接神经网络)需预留 |
| 散热 | 双360mm水冷 | 满载训练时CPU持续高负载 |
| 操作系统 | Ubuntu 22.04 LTS / Windows 11 | Python生态友好 |
预估性能: 20,000特征 × 500样本 × 200棵树,sklearn训练时间约 5-15分钟。
方案B:课题组级高性能工作站(中等规模,十万级特征)
适用场景: 单细胞测序(10x Genomics)、全基因组SNP筛选、多组学联合分析
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | AMD Threadripper PRO 7995WX (96核192线程) | 海量核心支持高并行度,八通道内存带宽 |
| 内存 | 512GB DDR5-4800 ECC | 十万级特征 × 万级样本 × 数百棵树,内存需求激增 |
| 存储 | 2TB NVMe SSD(系统)+ 8TB NVMe SSD(数据) | 单细胞数据矩阵动辄数十GB |
| 网络 | 万兆网卡 | 团队共享数据,NAS读写 |
| 散热 | 定制分体式水冷(600W+级) | 96核满载功耗超400W |
| 操作系统 | Ubuntu 22.04 LTS | 大内存支持更稳定 |
预估性能: 50,000特征 × 5,000样本 × 500棵树,ranger/sklearn训练时间约 30-60分钟。
方案C:企业级服务器/集群(大规模,百万级样本)
适用场景: 金融风控、推荐系统、工业质检,样本量百万级,特征数百至数千
表格
| 组件 | 推荐配置 | 说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9654 (96核×2 = 192核) | 超高核心密度,支持大规模并行 |
| 内存 | 1TB DDR5-4800 ECC | 百万级样本 × 千级特征 × 数百棵树 |
| 存储 | 全闪存阵列(NVMe SSD RAID)+ 分布式存储 | 高并发I/O,支持多用户同时训练 |
| 网络 | 双端口100GbE / InfiniBand HDR | 分布式训练低延迟通信 |
| GPU | 可选:NVIDIA A100 80GB × 2 | 后续扩展深度学习(XGBoost GPU版、神经网络) |
| 操作系统 | CentOS 7.9 / Rocky Linux 8.6 | 企业级稳定性,支持Spark/H2O分布式框架 |
预估性能: 百万样本 × 1,000特征 × 500棵树,Spark MLlib分布式训练时间约 1-3小时。
六、配置选型核心建议
1. CPU:核心数 > 单核性能
RF的树间并行是" embarrassingly parallel "(完全并行),理想加速比接近线性。因此:
-
优先选择高核心数平台(Threadripper PRO、EPYC)
-
单核主频对RF影响较小(树分裂是简单比较操作,非浮点密集)
-
避免超线程过度订阅:物理核心数 = 并行树数量时效率最高
2. 内存:容量是"硬门槛"
RF训练时需在内存中驻留:
-
原始数据矩阵(n × p)
-
Bootstrap样本矩阵(n × p × B棵树,但可复用原始数据)
-
每棵树的节点分裂统计量
经验公式: 内存需求 ≈ 原始数据大小 × 3-5倍。对于50,000特征 × 2,000样本的双精度矩阵(约800MB),建议预留 4-8GB;若并行训练100棵树,总内存需求约 32-64GB。
3. 存储:NVMe SSD是刚需
生信数据(.h5ad、.mtx、.csv)加载速度直接影响实验迭代效率。NVMe SSD(>3GB/s)相比SATA SSD(~500MB/s)可将数据加载时间从分钟级压缩到秒级。
4. GPU:非必需,但建议预留
RF本身不依赖GPU,但现代ML工作流通常是"RF特征筛选 → 深度学习精排"的混合 pipeline。预留一块中高端GPU(RTX 4060 Ti 16GB或A100),可无缝衔接后续深度学习任务。
5. 散热:持续高负载的保障
RF训练时CPU会长时间满载(尤其n_estimators较大时),风冷在满载下必然降频。水冷是保障持续性能的必要投资。
七、实战调参:用OOB曲线"榨干"硬件效率
Python
import numpy as np from sklearn.ensemble import RandomForestClassifier import matplotlib.pyplot as plt # 快速扫描n_estimators,找到OOB收敛点 n_estimators_range = [10, 25, 50, 100, 150, 200, 300, 500] oob_errors = [] for n in n_estimators_range: rf = RandomForestClassifier( n_estimators=n, oob_score=True, n_jobs=-1, # 用满全部CPU random_state=42 ) rf.fit(X_train, y_train) oob_errors.append(1 - rf.oob_score_) # 绘制OOB曲线,找到"拐点" plt.plot(n_estimators_range, oob_errors, 'o-') plt.xlabel('n_estimators') plt.ylabel('OOB Error') plt.axvline(x=200, color='r', linestyle='--', label='Convergence Point') plt.legend() plt.show()
核心策略: 先用小数据集快速扫描参数空间,确定收敛点后,再在完整数据上精调。这要求硬件支持快速迭代——SSD和大内存是关键。
八、结语:随机森林的"性价比哲学"
随机森林的流行,本质上是一种"性价比哲学"——它不需要标准化、不需要选核函数、不容易过拟合、还能输出特征重要性,真正做到了"开箱即用"。但这份"易用"背后,是对计算资源的隐性需求:高维数据吃内存、多树并行吃核心、Permutation Importance吃算力。
对于从事生物信息学、金融风控、遥感影像等领域的科研团队和数据科学家而言,投资一套与RF算法特性匹配的硬件平台,不是奢侈,而是缩短实验周期、提升模型迭代效率、产出高质量研究成果的必需。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


