






——从真空电子器件到半导体刻蚀,揭秘PIC-MCC仿真的硬件配置黄金法则
在微波管的真空腔体内,电子与残余气体分子的每一次碰撞都可能引发离子回流,导致器件性能劣化;在等离子体刻蚀机中,离子与中性粒子的碰撞能量分布直接决定晶圆的刻蚀精度。这些微观世界的"粒子舞蹈",长期以来都是电磁仿真领域的"黑箱"难题。
CST Studio Suite的粒子蒙特卡洛碰撞(MCC)功能,正是打开这扇黑箱的钥匙。但与其说它是一款软件模块,不如说它是一个跨越原子物理与工程应用的桥梁——在这里,麦克斯韦方程组与玻尔兹曼统计握手,概率模型与确定论仿真融合。
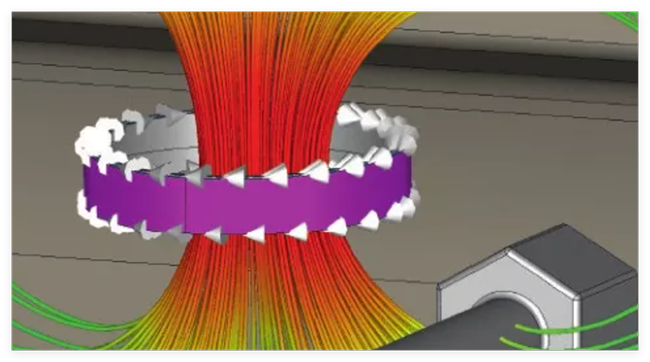
一、主要功能:五类碰撞模型构建的「微观物理宇宙」
CST MCC并非简单的"碰撞检测",而是一个基于第一性原理的随机物理建模平台,核心服务于PIC(Particle-in-Cell)与粒子追踪求解器:
1. 电子碰撞电离(Electron Impact Ionization)
核心能力:模拟高能电子轰击中性原子产生"离子-电子对"的过程 工程价值:
-
等离子体放电工况下的电子产生机制建模
-
气体开关击穿电压预测
-
电流守恒:确保仿真符合基尔霍夫定律
-
能量非守恒:电离能转化为二次电子动能,符合实验统计分布
2. 电子弹性散射(Elastic Scattering)
核心能力:电子与中性原子的"台球式"碰撞,改变动量但不显著损失能量 物理假设:原子质量>>电子质量(约1836倍),电子能量近似守恒 各向异性支持:可设置微分截面(Differential Cross Section)模拟定向散射
3. 电子激发(Excitation)
核心能力:电子将能量传递给原子,使其跃迁到高能级(但不电离) 门槛控制:必须导入激发阈值能量,低能电子自动过滤 后续效应:激发态原子退激发光,可用于光谱诊断仿真
4. 离子弹性散射(Ion-Neutral Elastic)
核心能力:离子与中性原子的动量交换,是离子温度弛豫的关键机制 与电子散射的本质区别:离子与原子质量相近,必须考虑原子反冲,能量重新分配遵循经典碰撞力学
5. 离子碰撞电离(Ion Impact Ionization)
核心能力:高能离子(如α粒子)引发的次级电离 能量分配:先扣除电离能,剩余能量通过弹性碰撞分配给产物粒子 速度分布:新生粒子服从麦克斯韦-玻尔兹曼分布
功能边界:MCC严格限定于"带电粒子+静态中性背景气体"场景,不支持库仑碰撞(带电粒子间)、中性-中性碰撞、表面二次发射等机制。
二、计算特点:概率模型的「数值稳定性」挑战
MCC的数学本质是随机采样算法,这决定了其独特的计算特征:
1. 双约束时间步长:稳定性与精度的拉锯战
MCC要求同时满足两个稳定性条件:
-
等离子体频率约束:ω_p × Δt << 1(确保粒子在单步内不跨越多个网格)
-
碰撞概率约束:ν × Δt << 1(确保单步内碰撞概率远小于1,通常<0.1)
工程影响:
-
高气压场景(>100 Torr)下,碰撞频率ν随气压线性增加,时间步Δt需压缩至10⁻¹⁵~10⁻¹⁶秒
-
模拟1μs的物理过程需要10⁹~10¹²个时间步,计算量呈指数级爆炸
2. 统计噪声:1/√N的「精度税」
MCC是蒙特卡洛方法,统计误差与粒子数的平方根成反比: Error∝Nparticles1
算力代价:
-
要将统计误差从10%降至1%,粒子数需增加100倍
-
低电离率、弱碰撞场景(如真空微放电)需要数亿级宏观粒子才能达到收敛
3. 截面数据的「内存墙」
MCC需导入能量相关的碰撞截面σ(E)数据:
-
电子碰撞通常需100~1000个能量点的截面数据
-
多组分气体(如CF₄/Ar/O₂混合刻蚀气体)需维护多张截面表
-
运行时需在每次碰撞查询中插值计算,造成随机内存访问模式,缓存命中率低
4. 并行计算的「负载不均衡」
-
粒子在空间上非均匀分布(如鞘层区密度高,体区密度低)
-
碰撞是随机事件,不同时间步的计算量波动大
-
MPI并行时易出现"某些进程空闲等待"的效率损失
三、硬件配置:PIC-MCC仿真的「算力铁三角」
针对MCC的计算特征,硬件配置需遵循"高频CPU+大内存+高速存储"的铁三角原则:
1. CPU:单核性能优先于核心数
关键指标:
-
主频≥3.5GHz:截面数据插值、碰撞判定逻辑是串行代码,高主频减少单粒子计算时间
-
大缓存≥30MB(L3):容纳频繁访问的截面数据表,减少内存延迟
-
AVX-512支持:加速粒子推进( Boris 算法)与场插值计算
推荐配置:
-
入门级:Intel Xeon 674X(28核,4.9GHz睿频,37.5MB L3)
-
进阶级:AMD EPYC 9655(96核,4.1GHz,384MB L3,适合多任务并行)
-
高端级:双路Intel Xeon Platinum 8592+(128核总计,3.9GHz,320MB L3)
2. 内存:容量与带宽的双重压力
容量需求:
-
2D模型:32GB~64GB(百万粒子+网格+截面数据)
-
3D模型:256GB~512GB(千万级粒子+高分辨率网格)
带宽优化:
-
8通道DDR5-5600 ECC:提供~300GB/s带宽,缓解随机内存访问瓶颈
-
NUMA亲和性:确保粒子数据存储在本地内存节点,避免跨Socket访问
3. 存储:随机I/O的「隐形杀手」
MCC仿真产生海量时间步数据(粒子轨迹、相空间分布、碰撞统计):
-
NVMe SSD必备:SATA SSD的随机IOPS(~10万)无法满足,需NVMe(~100万IOPS)
-
容量规划:单次3D仿真可能产生数TB的时序数据,建议配置:
-
系统盘:1TB NVMe(PCIe 4.0)
-
数据盘:4TB NVMe × 2(RAID 0)+ 16TB HDD(归档)
-
4. 专用加速(可选)
-
GPU加速:CST支持CUDA加速粒子推进(需NVIDIA A100/RTXPro6000),但MCC的碰撞判定逻辑复杂,GPU加速比有限(通常2-5倍)
-
高速互联:多机并行时使用InfiniBand HDR(200Gbps),减少MPI通信延迟
四、典型配置方案
方案A:真空电子器件仿真工作站(中小规模)
plain
CPU: Intel Core Ultra-270K plus (24核, 5.8GHz睿频) - 高主频利于单步计算
内存: 128GB DDR5-5600 (4通道)
存储: 2TB NVMe Gen4 + 8TB HDD
显卡: NVIDIA RTX 4080 16GB(可视化与轻度CUDA加速)
适用场景:微波管离子回流分析、小型等离子体源设计
方案B:半导体工艺仿真服务器(大规模3D PIC-MCC)
plain
CPU: 双路 AMD EPYC 9755 (256核总计, 3.0-4.1GHz, 512MB L3)
内存: 512GB DDR5-5600 ECC (16通道, 带宽>700GB/s)
存储: 8TB NVMe SSD (企业级U.2) + 50TB RAID6 HDD阵列
网络: 100GbE (集群扩展)
适用场景:ICP刻蚀机腔体仿真、大型容性耦合等离子体反应器
方案C:高统计精度专用节点(蒙特卡洛收敛优先)
plain
CPU: Intel Xeon 696X (64核, 4.8GHz, 336MB L3)
内存: 1TB DDR5-5600 ECC
存储: 全闪存阵列 (NVMe-oF)
特点:超大内存容纳超大规模粒子群(十亿级宏粒子),追求低统计噪声
结语:在确定与随机之间
CST MCC功能代表了工程仿真的一个哲学高度——用确定论的电磁场求解器(PIC)耦合随机论的碰撞模型(MCC),在宏观可预测与微观随机性之间找到平衡。
但这种平衡是有代价的:它吞噬算力,挑战内存,考验存储。当您的 workstation 风扇在深夜因十亿级粒子的碰撞计算而呼啸时,请记住——每一颗被模拟的电子,都在为下一代真空电子器件或5nm刻蚀工艺的突破铺就道路。
算力,即是洞察微观世界的显微镜。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800

本文基于沈风顺《CST粒子蒙特卡洛碰撞(MCC)功能详解》及PIC-MCC数值方法学理整理


