






核心结论:仿真软件正在 democratize 航空航天与工程仿真。波兰SpaceForest用Ansys Fluent替代风洞完成火箭气动分析、美国Specter Aerospace用nTop参数化设计加速高超声速飞行器迭代、英国BAR Technologies用NX+Simcenter STAR-CCM+结合神经网络优化游艇船型——这三件事的共同底座,是参数化几何生成+成熟求解器+批量算例算力。而对小团队来说,这套配置的硬件门槛正在被UltraLAB等方案快速拉低。
一、引言:当"风洞崇拜"遇上仿真民主化
造一枚能飞到一百公里高空的火箭,过去是国家级项目的活儿。你得有风洞,得耗上几年,还得养一屋子气动工程师天天改模型。
这是微信公众号"半支烟CFD饭圈"在2026年9月13日发布的一篇热门文章《听说风洞不再是入场券,小公司买套仿真软件就敢造火箭!》开篇的第一句话。这篇文章迅速在工程仿真圈引发热议,因为它描述的不是未来愿景,而是正在发生的现实。
这篇文章讲了三个故事:
- 波兰SpaceForest:一家没有风洞的私营火箭公司,用Ansys Fluent在电脑里算出了整枚火箭PERUN各个飞行阶段的气动数据,连热气动加热都算上了,火箭几次带着科研载荷飞行都成功了。
- 美国Specter Aerospace:高超声速飞行器设计公司,把几何建模挪进nTop,搭出参数化飞行器模型,改一个数模型自动更新,五天比了八种方案,冷却流道迭代从一天缩到二十分钟。
- 英国BAR Technologies:做美洲杯帆船的团队,用NX脚本一口气生成几千个船体几何,丢给Simcenter STAR-CCM+批量跑CFD,数据喂给神经网络做优化,几个小时自动造出上千个几何。
这三个案例的共同点是什么? 没有一家在自建软件,用的都是市面上买得到的工具。真正变了的是三样东西凑到了一起:参数化的几何生成、成熟到能顶替一部分风洞的求解器、跑得起批量算例的算力。
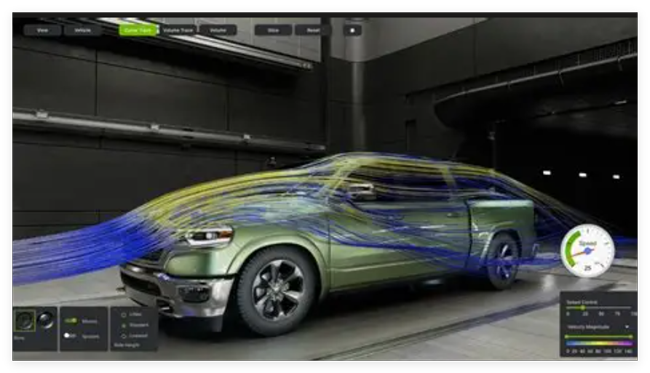
图1:CFD气动仿真计算结果可视化示意
而今天,我们要做的不只是复述这三个故事——我们要用AI的视角去拆解它们背后的核心算法、计算特点,以及:如果你也想搭建这样的仿真+AI工作流,UltraLAB的硬件到底该怎么选?
二、AI分析:三则案例的技术解构
2.1 SpaceForest:用仿真填补风洞空白
SpaceForest的PERUN火箭烧的是笑气和石蜡混合推进剂,还能回收再用。麻烦出在波兰国内没有风洞容得下它的完整尺寸,就算有,风洞吹出的速度也够不上真实飞行速度。气动系数拿不到,控制舵面和飞行稳定性就无从谈起。SpaceForest的工程师换了个思路,用Ansys Fluent在电脑里把各个飞行阶段的气流走了一遍,稳定性、控制舵面、载荷安全,连摄像头外壳那种部件的热气动加热都算上了。这活儿他们拉着渠道伙伴Symkom一起干。PERUN后来几次带着科研载荷飞,都成了,公司还打算把这套仿真接着用到未来的入轨任务里。
AI分析视角:SpaceForest的做法本质上是用数值模拟替代物理实验,这是一种"计算实验科学"的范式转移。传统工程验证流程是:设计→造原型→风洞测试→修改→再测试。而SpaceForest的流程变成了:设计→CFD仿真→(部分风洞验证)→修改→仿真验证→制造。仿真从"辅助工具"变成了"第一验证手段"。
| 传统流程 | SpaceForest流程 | AI分析价值 |
|---|---|---|
| 风洞测试为主 | CFD仿真为主 | 仿真覆盖风洞够不着的飞行阶段 |
| 物理原型迭代 | 数字原型迭代 | 迭代成本从百万级降到千元级 |
| 气动工程师手动调参 | AI Agent自动扫描参数空间 | 批量工况自动化,工程师聚焦物理判断 |
| 单一工况验证 | 多工况并行仿真 | GPU集群加速,天数级任务缩到小时级 |
2.2 Specter Aerospace:参数化设计消灭"几何抢救"
高超声速飞行器的外形、动力集成和内部结构是绑在一起动的。用传统CAD画一个方案还行,一改就散,机翼后掠角动一下,或者把进气道角度拧个十五度,下游的几何跟着遭殃,工程师一整天都在抢救崩掉的特征树,哪还有空去比较方案。Specter干脆把几何这摊子事挪进了nTop。他们和nTop的工程师关起门来干了三天,搭出一个参数化的飞行器模型,机身直径、长度、后掠角、进气道位置、燃烧室接口、管道走向,全做成了能拧的旋钮。改一个数,模型自己更新,还能直接接进他们的多学科优化流程,不用再手工清几何。原本要两三周才做得出来的参数化模型,两天就到手了。五天里,他们用同一个模型比了八种机身、发动机和整机封装方案。到了再生冷却燃烧室,把冷却流道从八十条改成一百条,迭代时间从一整天缩到二十分钟。他们那位干了二十五年的技术总监说,这是他见过最顺手的方案工具。
AI分析视角:Specter的做法是将设计空间参数化,把工程师的"手工修图"变成"旋钮调节"。这背后是参数化建模技术(Parametric CAD)与多学科优化(MDO)的融合。更深层看,这其实是将领域知识编码为约束规则的过程——老工程师的经验被写进参数化模型里,新人也能跑出专业级方案。
| 传统CAD流程 | nTop参数化流程 | 效率提升 |
|---|---|---|
| 改一个参数抢救半天 | 改一个数模型自动更新 | 几何重建时间:天→秒 |
| 方案比较靠手工建模 | 参数扫描自动批量生成 | 8种方案5天完成 |
| 冷却流道迭代需一整天 | 80条→100条迭代20分钟 | 迭代速度提升30倍+ |
| 几何与仿真割裂 | 参数化模型直接接优化流程 | 设计-仿真-优化闭环 |
2.3 BAR Technologies:AI驱动的设计自动化
英国游艇品牌Princess想造一条入门级运动艇,找上了做美洲杯帆船的BAR Technologies。这条船叫R35,船体全碳纤维,还带一对能自动调角度的水翼,巡航时最多能省下三成油。它的船型不是靠一个方案反复磨出来的,而是用NX的脚本一口气生成几千个船体几何,再丢给Simcenter STAR-CCM+一批一批地跑CFD,跑出来的数据喂给神经网络做优化。按BAR造船工程师的说法,几个小时就能自动造出上千个几何,然后从几百万种可能的船型里挑出那个最好的。这套打法让结构设计和详细设计能一边优化船体一边往前推,从概念到下水,前后花了十八个月。
AI分析视角:这是典型的AI for Science范式——用机器学习代理模型(Surrogate Model)替代高成本的CFD求解。核心逻辑是:先用少量高保真CFD样本训练神经网络,然后用训练好的网络快速预测新设计的气动性能,只在关键节点用真实CFD验证。这实现了"以假乱真"的加速优化。
| 环节 | 传统方式 | BAR的AI驱动方式 | 计算特点 |
|---|---|---|---|
| 几何生成 | 工程师手工建模 | NX脚本批量生成数千几何 | CPU多核并行 |
| CFD求解 | 单工况串行计算 | 批量并行CFD求解 | GPU大规模并行 |
| 设计优化 | 工程师经验试错 | 神经网络代理模型优化 | GPU张量计算 |
| 最终验证 | 全量CFD | 关键节点CFD验证 | 混合精度计算 |
三、核心算法与计算特点
3.1 CFD仿真核心算法
CFD(Computational Fluid Dynamics,计算流体力学)是这些案例的技术底座。其核心算法包括:
| 算法类别 | 代表方法 | 计算特点 | 硬件需求 |
|---|---|---|---|
| 有限体积法(FVM) | Ansys Fluent核心求解器 | 守恒性好,适合工程流动问题 | GPU加速迭代求解 |
| 有限元法(FEM) | Simcenter STAR-CCM+ | 适合复杂几何和多物理场耦合 | 大内存+多核CPU |
| 有限差分法(FDM) | 结构化网格求解 | 精度高但几何适应性差 | 高算力GPU |
| 离散 ordinate 法(DOM) | 辐射传热计算 | 角度离散+空间离散 | GPU并行 |
| k-epsilon/k-omega湍流模型 | 工程湍流模拟 | 计算成本低,工程精度够用 | 中等算力 |
| DES/LES大涡模拟 | 高精度湍流解析 | 网格数百万级,精度高成本高 | 大显存+多GPU |
计算特点总结:
- 网格依赖性:网格数从几十万到数亿不等,网格质量直接影响求解精度和收敛速度
- 迭代收敛:CFD是迭代求解过程,需要达到残差收敛标准,迭代次数从几百到几万不等
- 并行计算:大规模CFD天然适合GPU并行加速,单卡与多卡相比可提速5-10倍
- 内存带宽敏感:每次迭代需要读取整个网格和流场数据,内存带宽是关键瓶颈
- I/O密集:大规模网格文件和结果文件读写频繁,NVMe SSD显著提升效率
3.2 参数化建模核心算法
nTop等平台的核心算法是构造实体几何(CSG)+ 参数化约束求解:
| 算法模块 | 技术实现 | 计算特点 |
|---|---|---|
| 参数化几何内核 | 约束求解器+特征树 | 改参即更新,O(1)复杂度 |
| 自动网格划分 | 前沿推进法/包裹法 | 几何复杂度决定网格质量 |
| 多学科耦合接口 | FMI/FMU标准 | 跨软件数据交换,接口开销 |
| 设计空间探索 | 拉丁超立方采样+响应面 | 样本数=维度^阶数,维数灾难 |
3.3 AI代理模型核心算法
BAR Technologies案例中的AI优化流程涉及:
| 算法 | 作用 | 计算特点 |
|---|---|---|
| 高斯过程回归(GPR) | 代理模型构建 | 小样本精度高,预测速度快 |
| 深度学习代理模型 | 大规模设计空间映射 | 需要大量训练数据,推理极快 |
| 贝叶斯优化 | 高效搜索最优设计 | 平衡探索与利用,收敛快 |
| 遗传算法/粒子群 | 多目标优化 | 并行评估,GPU加速明显 |
| PINN物理信息神经网络 | 替代部分CFD求解 | 嵌入物理约束,精度依赖训练 |
四、UltraLAB硬件配置怎么选:仿真+AI双场景
4.1 选型核心原则
仿真计算是 "GPU显存密集 + 内存容量密集 + 存储I/O密集 + CPU多核并行" 的四重叠加场景,选型遵循以下原则:
- 显存容量决定仿真规模:32GB适合小型网格验证,48GB适合中等规模CFD和32B级AI模型,80GB~96GB适合大规模气动仿真和70B级模型
- 显存带宽决定求解速度:HBM3e > GDDR6X > GDDR6,带宽直接影响CFD迭代速度和AI推理速度
- CPU多核决定预处理效率:网格生成、数据预处理、NX脚本执行依赖CPU多核性能
- 内存容量决定并发能力:多工况并行CFD+AI推理需要256GB~512GB大内存
- NVMe SSD是刚需:大规模网格文件(几十GB)和结果文件(数百GB)需要高速存储
- 散热决定稳定性:CFD仿真7x24小时满载运行,必须配备工业级散热方案
4.2 GPU选型决策矩阵(仿真+AI双场景)
| GPU平台 | 显存 | 仿真定位 | AI定位 | 典型应用 |
|---|---|---|---|---|
| RTX 5090 水冷 | 32GB | 小型网格CFD验证 | 个人AI开发/RAG验证 | 学习验证、轻量仿真 |
| RTX 4090 48G水冷定制版 | 48GB | 中等规模CFD | 32B模型推理/LoRA微调 | 中小企业仿真+AI混合 |
| RTX PRO 5000 48G | 48GB | 工程级CFD仿真 | 企业AI/科研/RAG | 专业仿真+AI Agent开发 |
| A100 80G水冷定制版 | 80GB | 大规模CFD/多物理场 | 70B模型推理/全参数微调 | 高端仿真+大模型生产服务 |
| RTX PRO 6000D | 84GB | 大规模CFD/数字孪生 | 70B级模型/多模态Agent | 专业仿真+AI混合负载 |
| RTX PRO 6000 96G | 96GB | 超大规模CFD/全尺寸气动 | 70B级模型/多用户并发 | 旗舰仿真+AI平台 |
4.3 四级配置方案推荐
方案A:仿真开发工作站(预算2~4万)
适合:个人学习CFD、小型网格验证、AI仿真工具开发、轻量AI推理。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 265K(20核,最高睿频5.5GHz) | 高频多核,加速网格生成和预处理 |
| GPU | RTX 5090 32G + 水冷 | 消费级旗舰,性价比最高 |
| 内存 | 64GB DDR5 | 满足单用户仿真+开发需求 |
| 存储 | 4TB NVMe + 8TB SATA | 网格文件+数据集双盘方案 |
| 机箱/电源 | 塔式(2000W) | 保障持续满载稳定运行 |
| 参考价格 | 约 42000~62000 元 | UltraLAB A350系列 |
方案B:专业仿真+AI工作站(预算5~8万)
适合:中等规模CFD仿真、AI Agent开发、企业知识库RAG、LoRA微调。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 265K(20核,最高睿频5.5GHz) | 高频多核,平衡算力与功耗 |
| GPU | RTX PRO 5000 48G | 专业卡,ECC纠错,7x24稳定 |
| 内存 | 96GB DDR5 | 支持多工况并行仿真 |
| 存储 | 4TB NVMe + 8TB SATA | 大容量网格和结果文件 |
| 机箱/电源 | 塔式(2000W) | 工业级散热方案 |
| 参考价格 | 约 79000~93500 元 | UltraLAB A350系列 |
方案C:仿真超级工作站(预算9~15万)
适合:大规模CFD气动仿真、70B级模型本地部署、多模态AI、高级QLoRA微调。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | Intel Ultra 270K Plus(24核,最高睿频5.5GHz) | 更多核心,加速批量仿真和AI推理 |
| GPU | RTX PRO 5000 72G 或 A100 80G | 大显存支撑大规模仿真和70B模型 |
| 内存 | 192GB DDR5 | 企业级多工况并行+大知识库 |
| 存储 | 4TB NVMe + 8TB SATA | 海量网格文件和结果数据 |
| 机箱/电源 | 塔式(2200W) | 高端散热保障 |
| 参考价格 | 约 132000~149000 元 | UltraLAB A350系列 |
方案D:多GPU仿真训练服务器(预算20~80万+)
适合:企业级CFD集群、大规模参数扫描、大模型全参数训练、多用户仿真+AI平台。
| 硬件模块 | 推荐配置 | 选型逻辑 |
|---|---|---|
| CPU | AMD 霄龙7763(64核 2.45~3.5GHz) | 服务器级多核,分布式仿真+训练 |
| GPU | 2~8x RTX 4090 48G / Pro 6000 96G / H20 140G | 多卡并行,显存池化 |
| 内存 | 256GB~768GB DDR4 | 超大规模网格+多模型并发 |
| 存储 | 8TB NVMe + 8TB SATA(多盘位) | 高速网格加载+海量存储 |
| 机箱/电源 | 双塔式(2x2000W) / 机架式 | 企业级可靠性 |
| 参考价格 | 约 212000~1450000 元 | UltraLAB AE430/GA650M/GA658系列 |
五、软件清单:从裸机到可生产的仿真+AI工具链
5.1 CFD仿真核心软件栈
| 分类 | 工具/框架 | 核心用途 | 硬件要求 |
|---|---|---|---|
| CFD求解器 | Ansys Fluent / Simcenter STAR-CCM+ | 流场仿真、气动分析、热分析 | GPU加速+大显存 |
| 前处理/网格 | ANSA / HyperMesh / Pointwise | 几何清理、网格生成 | 多核CPU+大内存 |
| 后处理 | Tecplot / ParaView / Ansys CFD-Post | 流场可视化、数据分析 | GPU渲染 |
| 参数化建模 | nTop / NX / Catia | 参数化几何生成、多学科设计 | 多核CPU+大内存 |
| 优化框架 | modeFRONTIER / Isight / Dakota | 设计优化、参数扫描 | 多GPU并行 |
| 脚本自动化 | Python / Julia / MATLAB | 流程自动化、数据处理 | 通用 |
5.2 AI大模型本地部署软件栈
| 分类 | 工具/框架 | 核心用途 | 硬件要求 |
|---|---|---|---|
| 操作系统 | Ubuntu 24.04 LTS(首选)/ Windows 11 Pro | 系统基础环境 | 通用 |
| Python环境 | conda隔离 + Python 3.10~3.12 | 依赖管理与环境隔离 | 通用 |
| 容器化 | Docker + NVIDIA Container Toolkit | 模型环境隔离与复现 | 通用 |
| GPU驱动 | NVIDIA Studio/数据中心驱动 | AI计算稳定性 | NVIDIA GPU |
| AI推理框架 | vLLM / Text Generation Inference | 大模型高效推理服务 | 大显存GPU |
| 模型加载器 | llama.cpp / Ollama / LM Studio | 本地模型运行 | 通用(支持多GPU) |
| AI Agent框架 | LangChain / AutoGen / CrewAI | AI智能体开发 | 大显存+大内存 |
| 向量数据库 | Chroma / Milvus / Faiss | RAG知识库检索 | 大内存 |
| 开发工具 | Jupyter Notebook / VS Code | 模型开发与调试 | 通用 |
5.3 仿真+AI融合工具链
| 工具 | 用途 | 与UltraLAB的适配 |
|---|---|---|
| Ansys Fluent + AI加速 | CFD求解+AI代理模型 | A100/Pro 6000系列GPU加速 |
| nTop + 优化闭环 | 参数化设计+自动优化 | 多核CPU+大内存预处理 |
| Simcenter STAR-CCM+ | 多物理场耦合仿真 | 多GPU并行求解 |
| NX + CFD自动化 | 脚本批量生成+仿真 | 高频CPU+大内存 |
| Python + PyTorch | AI代理模型训练 | 多GPU训练集群 |
| Docker + Kubernetes | 仿真任务调度 | 机架式集群方案 |
5.4 部署环境建议
- 操作系统:Ubuntu 24.04 LTS(首选,驱动兼容性最佳)/ Windows 11 Pro(兼容性好)
- Python环境:conda隔离 + Python 3.10~3.12,避免依赖冲突
- 容器化:Docker + NVIDIA Container Toolkit,便于模型环境隔离与复现
- 驱动:NVIDIA Studio/数据中心驱动(AI计算更稳定)
- 仿真软件许可:Ansys/NX/STAR-CCM+等商业软件许可费用可能超过硬件本身,采购前需预算评估
六、应用场景:谁需要仿真+AI算力?
| 应用场景 | 主要需求 | 推荐显存 | 代表工具 |
|---|---|---|---|
| 航空航天气动仿真 | 全尺寸火箭/飞行器CFD、多工况并行 | 48GB~96GB | Ansys Fluent、STAR-CCM+ |
| 汽车空气动力学 | 整车风阻优化、热管理仿真 | 48GB~80GB | STAR-CCM+、Simulink |
| 船舶与海洋工程 | 船型优化、水动力学仿真 | 48GB~96GB | STAR-CCM+、OpenFOAM |
| 建筑风工程 | 风荷载分析、风环境模拟 | 32GB~48GB | Ansys Fluent、OpenFOAM |
| AI驱动设计优化 | 代理模型训练、批量参数扫描 | 48GB~96GB | PyTorch+CFD求解器 |
| 数字孪生 | 实时仿真+AI预测 | 80GB~96GB | 多GPU集群 |
| 企业知识库/RAG | 仿真文档检索、知识问答 | 32GB~48GB | Qwen2.5、DeepSeek |
| AI仿真Agent | 自动操作仿真软件工作流 | 48GB~96GB | LangChain+CFD工具链 |
回到文章开头的三个案例:SpaceForest需要的是大规模CFD仿真算力(方案C/D),Specter需要的是参数化建模+快速迭代的CPU算力(方案B/C),BAR需要的是AI训练+批量CFD的混合算力(方案C/D)。它们的共同趋势是:仿真和AI在同一台机器上跑。
七、大模型本地部署:让AI操作仿真软件
7.1 为什么仿真领域需要大模型本地部署?
仿真的痛点不仅仅是"算得慢",更是"用得烦":
- 设置复杂:网格划分、边界条件设置、求解参数调优需要资深工程师
- 迭代漫长:改一个参数→重新网格→重新求解→后处理,一轮可能几天
- 知识孤岛:老工程师的经验不在系统里,人走了经验就没了
- 工具割裂:CAD→网格→求解→后处理,软件之间数据传递繁琐
大模型本地部署的价值在于:让AI Agent成为仿真工作流的"操作系统"——你告诉AI"帮我优化这个机翼的升阻比",AI自动完成参数修改、网格重划、求解计算、结果对比的全流程。
7.2 仿真AI Agent的技术架构
| 层级 | 组件 | 功能 |
|---|---|---|
| 自然语言接口 | LLM(Qwen/DeepSeek本地部署) | 理解工程师的自然语言指令 |
| 任务规划 | Agent框架(LangChain/AutoGen) | 拆解仿真任务为可执行步骤 |
| 工具调用 | API/脚本调用CFD求解器 | 自动操作仿真软件 |
| 知识检索 | RAG+向量数据库 | 检索历史仿真案例和工程经验 |
| 结果解释 | LLM生成报告 | 自动生成仿真分析报告 |
7.3 硬件需求分析
运行一套完整的仿真AI Agent系统需要:
- LLM推理:70B级模型需要80GB+显存(A100/Pro 6000)
- RAG检索:大规模向量数据库需要256GB+内存
- CFD求解:大规模网格需要GPU并行加速
- 并发处理:多用户同时使用需要多卡集群
推荐配置:方案C(单节点70B推理+仿真)或方案D(多用户并发+批量仿真)。
八、常见问题硬件配置分析(FAQ)
Q1:仿真计算和AI大模型部署,硬件需求有什么不同?
仿真计算更依赖CPU多核性能+内存容量+存储I/O,因为网格生成和预处理是CPU密集型任务;AI大模型部署更依赖GPU显存容量+显存带宽,因为模型权重需要全部装入显存。理想方案是CPU和GPU都拉满的混合配置(如UltraLAB方案C/D)。
Q2:32GB显存能做航空航天级CFD仿真吗?
32GB显存适合小型网格的入门级CFD分析和学习验证。对于全尺寸火箭/飞行器的气动仿真(网格数千万级),建议48GB起步。如果同时跑AI模型,32GB会非常紧张。
Q3:仿真软件许可费用是多少?值得投入吗?
Ansys Fluent、Simcenter STAR-CCM+、NX等商业软件许可费用从几十万到上百万不等。但相比风洞建设(数千万到数亿元)和人工迭代成本,软件+算力的组合方案性价比极高。SpaceForest的案例证明:小团队用软件+算力也能做出国家级水平的仿真分析。
Q4:AI代理模型能替代CFD求解吗?
目前不能完全替代,但正在快速逼近。PINN(物理信息神经网络) 等新技术正在缩小差距。短期内的最佳实践是混合方案:用AI代理模型做快速筛选,用CFD做关键节点验证。这需要同时具备AI训练和CFD求解的算力。
Q5:NVMe Gen5 SSD对仿真有帮助吗?
非常有帮助。 大规模CFD网格文件(几百MB到几GB)和结果文件(几十GB)的读写频繁。NVMe Gen5(14GB/s)可将网格加载时间从分钟级缩短到秒级,批量任务队列中优势明显。
Q6:仿真需要多少内存?
取决于网格规模和并行工况数:
| 网格规模 | 推荐内存 | 适用场景 |
|---|---|---|
| < 100万网格 | 64GB | 学习验证、小型分析 |
| 100万~1000万网格 | 96GB~192GB | 工程级仿真 |
| 1000万~1亿网格 | 256GB~512GB | 大规模气动仿真 |
| > 1亿网格 | 512GB+ | 全尺寸飞行器仿真 |
Q7:本地部署DeepSeek/Qwen用于仿真AI Agent应该买什么配置?
| 模型规模 | 推荐GPU | 适用场景 |
|---|---|---|
| 7B~14B | RTX 5090 32GB | 轻量Agent、仿真文档问答 |
| 32B | RTX PRO 5000 48GB | 企业仿真Agent、RAG知识库 |
| 70B量化 | 48GB~96GB | 高级仿真Agent、多模态 |
| 70B FP16/BF16 | 2x80GB/96GB级GPU | 科研验证、高精度推理 |
| 100B+ | 多GPU服务器 | 企业AI平台、多用户服务 |
Q8:风洞真的会被仿真完全替代吗?
不会。 正如原文所说:"风洞没被淘汰,它只是不再是唯一的答案。"仿真的优势在于灵活性和成本,风洞的优势在于真实性和认证权威性。最佳实践是仿真为主、风洞验证为辅的混合验证策略。而让这套策略运转起来的算力底座,就是本文讨论的UltraLAB硬件方案。
九、总结与选型结论
9.1 选型路线一张图
32GB  →  仿真学习 / 小型CFD / AI开发 / RAG
  ↓
48GB  →  工程级CFD / 32B模型 / 企业Agent / QLoRA
  ↓
80GB~96GB  →  大规模仿真 / 70B模型 / 多模态 / 多用户
  ↓
4~8 GPU  →  仿真集群 / 大模型训练 / 企业AI平台 / 数字孪生
9.2 结论
- 个人学习/小型仿真用户:首选 RTX 5090 32GB 水冷工作站(方案A),入门门槛最低
- 专业仿真+AI混合用户:首选 RTX PRO 5000 48GB(方案B),性价比最佳的工程级配置
- 大规模仿真+70B模型用户:首选 A100 80GB 或 RTX PRO 6000 96GB(方案C),旗舰单节点方案
- 企业级仿真集群+多用户AI平台:选择多GPU级 UltraLAB AI服务器(方案D),并配置高速网络和分布式计算软件
选型理念:采购前明确以下信息——仿真网格规模和求解器类型、是否需要AI代理模型训练、是否需要多工况并行、是否需要多用户并发、是否需要大模型本地部署。UltraLAB可据此对CPU、GPU、内存、NVMe、网络、电源及散热进行定制化设计,实现"算法匹配优先于配置堆砌"。
9.3 写在最后
SpaceForest、Specter Aerospace、BAR Technologies这三个故事告诉我们一个清晰的趋势:工程仿真的民主化已经到来。参数化设计让几何建模不再是瓶颈,成熟求解器让仿真精度接近风洞,AI让仿真从"工程师手工操作"变成"AI Agent自动执行"。
而这一切的底座,是一台够力的计算设备。
选择一台合适的UltraLAB工作站或服务器,不是买一块显卡或一台服务器,而是为接下来三到五年的仿真+AI工作流,打下一台不会掉链子的算力底座。风洞不再是唯一的答案,但算力必须是——因为当AI开始操作仿真软件的时候,它需要的不是一间风洞实验室,而是一台24小时待命的本地超级计算机。
关于UltraLAB:西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注于AI大模型、科学计算、工程仿真等领域的异构超算解决方案。业务咨询:400-705-6800。
本文参考来源:微信公众号"半支烟CFD饭圈"文章《听说风洞不再是入场券,小公司买套仿真软件就敢造火箭!》(https://mp.weixin.qq.com/s/FX4MQs_OQVrOrgr27qWxNw)、UltraLAB 2026v3深度学习基准配置方案。


