






生成式AI分子设计大模型本地部署指南——UltraLAB工作站硬件配置全解析
摘要:2026年,生成式AI已从药物研发的"概念验证"阶段迈入"生产就绪"阶段。扩散模型、Transformer化学语言模型与图神经网络(GNN)的融合,使AI能够在数秒内设计出具有特定药理性质的新分子,将早期药物发现周期从4-6年压缩至12-18个月。本文将系统解析生成式AI分子设计的核心技术栈、主流大模型本地部署方案,以及UltraLAB工作站的硬件配置策略,为药企研发部门与高校科研团队提供可落地的参考。
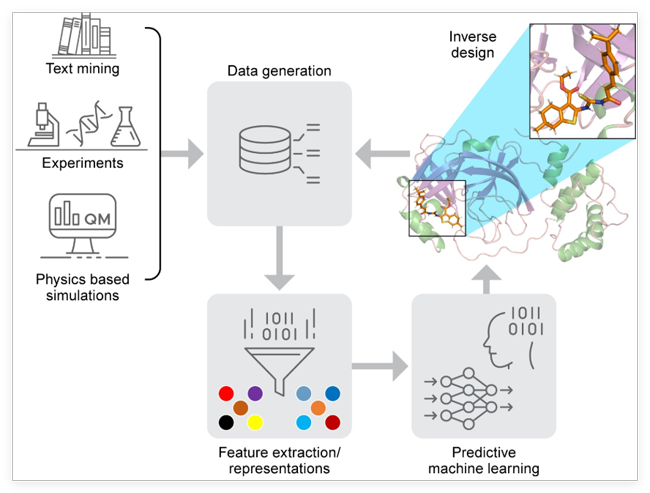
一、生成式AI分子设计:从算法到药物的范式革命
1.1 技术演进:从CADD到生成式AI
传统计算机辅助药物设计(CADD)依赖物理计算筛选已知化合物库,而生成式AI的核心突破在于**"创造"而非"搜索"**——模型能够提出从未被合成过的分子结构,并同时优化 potency、选择性、ADME、毒性及合成可行性等多维属性。
2026年的关键进展包括:
- 属性特异性生成:模型可同时针对溶解度、结合亲和力、稳定性与可合成性进行多目标优化
- 反应路径预测:生成系统不仅输出分子,还同步提供完整合成路线建议
- 不确定性量化:领先平台为预测结果提供置信度评分,帮助研究人员优先筛选物理验证候选分子
- AI生成药物分子I期临床试验成功率已达80%-90%,远超历史平均水平(35%-50%)
1.2 主流生成模型架构对比
| 模型类型 | 核心原理 | 最佳适用场景 | 代表模型/工具 |
|---|---|---|---|
| Transformer / 化学语言模型 | 将分子视为序列(SMILES/SELFIES),学习化学语法生成新分子 | 大规模分子生成、属性条件设计 | MoLeR, REINVENT 4, MolGPT |
| 扩散模型(Diffusion Model) | 从随机噪声逐步去噪生成3D分子结构,可在结合口袋内直接设计 | 基于结构的从头设计(Structure-based De Novo) | DiffSBDD, Pocket2Mol, E(3)-等变扩散模型 |
| 图神经网络(GNN) | 将分子表示为原子-键图,预测结构与性质关系 | 性质预测、分子优化 | DimeNet++, SchNet, MEGNet |
| 变分自编码器(VAE) | 学习分子的连续隐空间,支持插值与可控探索 | 分子空间插值、先导化合物优化 | Junction Tree VAE, Grammar VAE |
| 强化学习(RL) | 通过与奖励函数交互迭代优化分子属性 | 多属性先导优化、合成可行性约束 | REINVENT系列, GENTRL |
关键洞察:扩散模型在2026年已成为3D分子生成的主导架构,E(3)-等变扩散模型能够在保持分子几何对称性的同时,直接在靶点蛋白结合口袋内生成高亲和力配体。
二、分子设计AI大模型本地部署:核心软件栈
2.1 开源大模型与框架清单
(1)分子生成与优化
| 软件/模型 | 类型 | 核心功能 | 硬件依赖 | 许可证 |
|---|---|---|---|---|
| REINVENT 4 | 开源工具包 | 基于RL的分子从头设计与优化 | GPU (CUDA) | MIT |
| GuacaMol | 开源基准框架 | 分子生成模型评估与基准测试 | GPU/CPU | MIT |
| MoLeR | 开源模型 | 基于Transformer的分子生成与优化 | GPU (PyTorch) | Apache-2.0 |
| Difflinker | 开源工具 | 3D分子连接子(Linker)设计 | GPU (CUDA) | MIT |
| Pocket2Mol | 开源模型 | 基于扩散模型的结合口袋分子生成 | GPU (PyTorch) | MIT |
| DiffSBDD | 开源模型 | 结构-based药物设计的扩散模型 | GPU (PyTorch) | MIT |
| SyntheMol | 开源工具 | 合成可及性约束的分子生成 | GPU/CPU | MIT |
(2)蛋白质结构预测与相互作用
| 软件/模型 | 类型 | 核心功能 | 硬件依赖 | 许可证 |
|---|---|---|---|---|
| AlphaFold3 | 开源推理 | 蛋白质-配体-核酸-离子复合物结构预测 | GPU (CUDA, 显存≥40GB推荐) | 学术免费 |
| ColabFold | 开源工具 | AlphaFold2的优化本地部署版本 | GPU (CUDA) | MIT |
| OpenFold | 开源复现 | AlphaFold2的PyTorch开源复现 | GPU (CUDA) | Apache-2.0 |
| Boltz-1 | 开源模型 | 生物分子复合物结构预测 | GPU (CUDA) | MIT |
| Chai-1 | 开源模型 | 蛋白质-配体相互作用预测 | GPU (CUDA) | 学术免费 |
(3)分子动力学与自由能计算
| 软件/模型 | 类型 | 核心功能 | 硬件依赖 | 许可证 |
|---|---|---|---|---|
| GROMACS 2026.x | 开源MD引擎 | 高性能分子动力学模拟,支持GPU加速 | GPU (CUDA/OpenCL) | LGPL |
| OpenMM | 开源MD引擎 | Python友好的分子动力学,支持自定义力场 | GPU (CUDA/OpenCL) | MIT |
| AMBER (GPU) | 学术版免费 | 生物分子模拟与自由能计算 | GPU (CUDA) | 学术免费 |
| NAMD 3.0 | 开源MD引擎 | 大规模并行分子动力学(支持百万原子体系) | GPU (CUDA) | 学术免费 |
| PMX | 开源工具 | 相对自由能微扰(FEP)计算 | CPU/GPU | LGPL |
| SOMD | 开源工具 | 溶剂化自由能计算 | GPU (OpenMM后端) | MIT |
(4)分子表示与性质预测
| 软件/模型 | 类型 | 核心功能 | 硬件依赖 | 许可证 |
|---|---|---|---|---|
| RDKit | 开源库 | 分子操作、描述符计算、子结构搜索 | CPU | BSD |
| DeepChem | 开源框架 | 深度学习在化学/材料中的应用 | GPU/CPU | MIT |
| DGL-LifeSci | 开源库 | 基于DGL的分子图神经网络 | GPU (PyTorch) | Apache-2.0 |
| TorchDrug | 开源框架 | 药物发现深度学习平台 | GPU (PyTorch) | Apache-2.0 |
| HuggingFace Transformers (Chem) | 开源模型 | 化学语言模型(ChemBERTa, MolFormer等) | GPU/CPU | Apache-2.0 |
(5)大模型推理与部署框架
| 软件 | 类型 | 核心功能 | 适用场景 |
|---|---|---|---|
| Ollama | 开源推理框架 | 一键部署大语言模型,支持量化推理 | 本地快速原型验证 |
| vLLM | 开源推理引擎 | 高吞吐、低延迟的LLM推理服务 | 企业级并发推理 |
| TensorRT-LLM | NVIDIA官方 | 针对NVIDIA GPU优化的LLM推理 | 生产环境高性能部署 |
| llama.cpp | 开源推理 | 跨平台CPU/GPU推理,支持多种量化 | 资源受限环境 |
| Triton Inference Server | NVIDIA官方 | 多框架模型服务化部署 | 企业级模型服务 |
2.2 商业软件补充(可选预装)
| 软件 | 厂商 | 核心功能 | 部署模式 |
|---|---|---|---|
| Schrödinger Maestro / FEP+ | Schrödinger | 基于物理的分子模拟与FEP计算 | 本地许可证 |
| MOE (Molecular Operating Environment) | Chemical Computing Group | 分子建模、药效团设计、蛋白质工程 | 本地许可证 |
| Flare | Cresset | 基于静电的分子设计与3D-QSAR | 本地许可证 |
| SeeSAR / infiniSee | BioSolveIT | 基于片段的分子设计、视觉筛选 | 本地/云端 |
| StarDrop | Optibrium | ADMET预测、多参数优化决策 | 本地许可证 |
| Discovery Studio | Dassault/BIOVIA | 综合分子模拟与药物设计平台 | 本地许可证 |
三、应用场景深度解析
3.1 靶点发现与验证(Target ID & Validation)
技术流程:多组学数据整合 → 蛋白质-蛋白质相互作用网络分析 → AI靶点优先级排序 → 分子动力学验证
核心计算特征:
- 大规模图神经网络训练(PPI网络分析)
- 长序列Transformer模型推理(基因组/蛋白质组数据)
- 内存密集型任务(需加载大规模生物网络数据)
硬件瓶颈:内存容量 > GPU显存 > CPU核心数
3.2 从头分子设计(De Novo Molecular Design)
技术流程:靶点结构解析(AlphaFold3/Chai-1)→ 结合口袋分析 → 扩散模型生成候选分子 → ADMET预测过滤 → 合成可行性评估
核心计算特征:
- 扩散模型推理:大量矩阵运算,显存占用高(3D坐标生成需存储中间态)
- 批量分子生成:高并发GPU计算,适合Tensor Core加速
- 后处理筛选:RDKit描述符计算(CPU并行友好)
硬件瓶颈:GPU显存容量 > GPU计算能力 > 内存带宽
3.3 先导化合物优化(Lead Optimization)
技术流程:活性分子骨架确定 → 强化学习/遗传算法优化 → 自由能微扰(FEP)排序 → 合成路线规划
核心计算特征:
- FEP计算:需要GPU加速的分子动力学模拟(ns级轨迹)
- 多目标优化:需同时评估活性、选择性、溶解度、毒性
- 迭代密度高:单次优化循环可能涉及数百个类似物评估
硬件瓶颈:GPU持续计算能力 > 显存容量 > 存储I/O
3.4 蛋白质工程与抗体设计
技术流程:抗原表位预测 → 抗体序列生成(ProteinMPNN/RFdiffusion)→ 亲和力成熟 → 可开发性评估
核心计算特征:
- 蛋白质结构预测:AlphaFold3推理需大显存(复合物结构预测)
- 序列-结构联合设计:需同时加载语言模型与结构预测模型
- 大规模虚拟筛选:百万级抗体序列的批量评估
硬件瓶颈:显存容量(>48GB)> 多GPU并行 > 内存容量
3.5 ADMET预测与毒性评估
技术流程:分子描述符计算 → 深度学习模型推理(吸收/分布/代谢/排泄/毒性)→ 多参数优化决策
核心计算特征:
- 图神经网络推理:中等计算量,适合批量处理
- 多模型集成:需同时加载多个预测模型
- 数据预处理:大规模分子库筛选(百万级化合物)
硬件瓶颈:内存容量 > GPU计算能力 > CPU核心数
四、UltraLAB工作站硬件配置方案
4.1 配置选型核心原则
生成式AI分子设计工作站的硬件选型需遵循以下优先级:
- GPU显存容量:决定可加载的模型规模与批量处理大小。扩散模型与AlphaFold3推理对显存极度敏感
- GPU计算能力:Tensor Core加速FP16/BF16推理,影响分子生成速度与FEP计算效率
- 系统内存:需为模型参数量的2倍以上,用于数据预处理与中间结果缓存
- 存储I/O:NVMe SSD为刚需,大模型加载与分子数据库读取对顺序/随机读写要求极高
- CPU与PCIe带宽:保障GPU数据供给,多卡场景下PCIe 5.0 x16避免瓶颈
4.2 分级配置推荐
方案A:入门级分子生成工作站(预算:4-6万元)
适用场景:高校课题组、初创药企、分子生成算法研究、中小型分子库虚拟筛选
| 组件 | 规格 | 选型说明 |
|---|---|---|
| CPU | Intel Core i9-14900K (24核32线程, 6.0GHz) 或 AMD Ryzen 9 9950X (16核32线程, 5.7GHz) | 高主频保障单线程性能,多核支持数据预处理并行 |
| GPU | NVIDIA RTX 4090 24GB ×1 | 单卡大显存,支持多数扩散模型与AlphaFold2推理;Tensor Core加速FP16推理 |
| 内存 | 64GB DDR5-6400 (2×32GB) | 满足32B以下模型加载与中等规模分子库处理 |
| 系统盘 | 2TB PCIe 4.0 NVMe SSD (Samsung 990 Pro / WD Black SN850X) | 快速系统响应与软件加载 |
| 数据盘 | 4TB PCIe 4.0 NVMe SSD | 分子数据库(ChEMBL, ZINC, PDB等)与模型权重存储 |
| 电源 | 1000W 80Plus Gold 全模组 | 单卡4090峰值功耗约450W,留足余量 |
| 散热 | 360mm AIO水冷 + 机箱风道优化 | 保障i9/9950X持续高频运行 |
| 网络 | 2.5GbE 有线网卡 | 数据集下载与模型权重更新 |
可运行模型/任务:
- REINVENT 4 分子生成与优化
- AlphaFold2 / ColabFold 单链蛋白质结构预测
- GROMACS 小型体系(<10万原子)GPU加速MD
- DeepChem / DGL-LifeSci 分子性质预测
- 7B-13B参数化学语言模型本地推理
方案B:专业级药物发现工作站(预算:10-15万元)
适用场景:中型药企计算化学部门、CRO公司、蛋白质-配体复合物结构预测、FEP计算、抗体设计
| 组件 | 规格 | 选型说明 |
|---|---|---|
| CPU | AMD Ryzen Threadripper PRO 7995WX (64核128线程, 5.1GHz) 或 Intel Xeon w9-3495X (56核112线程, 4.8GHz) | 超多核心支持大规模数据并行预处理与CPU fallback计算 |
| GPU | NVIDIA RTX 6000 Ada 48GB ×1 或 RTX 4090 24GB ×2 (NVLink桥接) | 48GB显存可运行AlphaFold3复合物预测;双卡4090通过NVLink实现显存池化 |
| 内存 | 128GB DDR5-6400 ECC (4×32GB) | 支持大型分子数据库内存映射与多模型并发加载 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD | PCIe 5.0提供翻倍带宽,加速大模型加载 |
| 数据盘 | 8TB PCIe 4.0 NVMe SSD (RAID 0 或独立双盘) | 超大规模分子库与轨迹文件存储 |
| 电源 | 1600W 80Plus Titanium 全模组 | 双卡/单卡专业卡高功耗场景稳定供电 |
| 散热 | 压缩机水冷系统 (500W-800W级) 或 分体式水冷 | Threadripper/至强持续满载散热保障 |
| 网络 | 10GbE 有线网卡 | 高速数据传输与集群互联 |
可运行模型/任务:
- AlphaFold3 蛋白质-配体-核酸复合物结构预测
- DiffSBDD / Pocket2Mol 基于结构的3D分子生成
- GROMACS / OpenMM 中型体系(50万原子)长时程MD
- 双卡并行FEP计算(AMBER GPU / Schrödinger FEP+)
- 32B参数化学多模态大模型本地推理
- 百万级分子库的ADMET批量预测
方案C:旗舰级AI制药计算平台(预算:25-40万元)
适用场景:大型药企AI药物发现中心、国家级实验室、抗体药物从头设计、大规模虚拟筛选、多模态生物医药大模型微调
| 组件 | 规格 | 选型说明 |
|---|---|---|
| CPU | 2× AMD EPYC 9755 (128核256线程, 5.0GHz) 或 2× Intel Xeon 6980P (128核256线程, 3.9GHz) | 双路服务器级CPU,极致并行计算与PCIe通道数 |
| GPU | NVIDIA RTX 6000 Ada 48GB ×2-4 或 RTX PRO 6000 96GB ×2 | 96GB显存支持超大复合物预测与全参数模型微调;多卡NVLink/NCCL互联 |
| 内存 | 256GB-512GB DDR5-6400 ECC Reg (8×32GB 或 8×64GB) | 支持TB级分子数据库内存计算与多任务并发 |
| 系统盘 | 2TB PCIe 5.0 NVMe SSD (企业级) | 高耐久企业级SSD,保障7×24稳定运行 |
| 数据盘 | 16TB-32TB NVMe SSD 阵列 (RAID 10 或独立多盘) | 分子动力学轨迹、大规模生成结果、模型检查点存储 |
| 电源 | 2000W-2400W 冗余电源 (80Plus Titanium) | 多卡旗舰平台稳定供电与冗余保护 |
| 散热 | 压缩机水冷系统 (800W-1000W级) 或 机房级液冷 | 双路CPU+多卡GPU极端功耗场景 |
| 网络 | 25GbE / 100GbE (Mellanox ConnectX-6/7) | 高速集群互联与大规模数据传输 |
| 机箱 | 4U机架式服务器或全塔工作站 | 多卡扩展与专业散热风道 |
可运行模型/任务:
- 多卡并行AlphaFold3批量结构预测
- RFdiffusion / ProteinMPNN 大规模蛋白质/抗体设计
- 全参数微调70B+参数生物医药大模型(LoRA/QLoRA)
- 百万原子级分子动力学(NAMD 3.0 GPU加速)
- 大规模FEP计算(>100个类似物同时评估)
- 多模态生物医药大模型(如ChatDD-FM 100B级量化推理)
4.3 显存与模型规模对照参考
| 模型/任务类型 | 推荐最低显存 | 推荐显存 | 备注 |
|---|---|---|---|
| REINVENT 4 / 小分子RL生成 | 8GB | 16GB+ | 批量大小影响显存占用 |
| AlphaFold2 单链预测 | 16GB | 24GB | 长序列需更大显存 |
| AlphaFold3 复合物预测 | 40GB | 48GB+ | 多链+配体显存需求剧增 |
| DiffSBDD / 3D扩散生成 | 24GB | 48GB+ | 3D坐标张量占用大 |
| GROMACS GPU MD (50万原子) | 16GB | 24GB+ | 取决于力场与 cutoff |
| FEP+ / 相对自由能计算 | 24GB | 48GB+ | 需同时运行多个副本 |
| 7B参数化学LLM (FP16) | 16GB | 24GB | 支持上下文长度8K |
| 32B参数化学LLM (FP16) | 48GB | 80GB+ | 需A100/H100级别 |
| 70B参数模型 (INT4量化) | 48GB | 96GB+ | RTX PRO 6000 96GB可单卡运行 |
五、常见问题与硬件配置分析
Q1:为什么分子生成任务中显存比算力更重要?
分析:生成式分子设计(尤其是扩散模型与3D生成)需同时存储:
- 模型权重参数(数十亿级别)
- 中间扩散状态张量(3D坐标网格,N×N×N维度)
- 批量候选分子的表示矩阵
- 优化器状态(训练/微调场景)
扩散模型的去噪过程需在显存中维护多时间步的中间态,3D分子表示的张量维度远高于2D图或1D序列。显存不足将直接导致 batch size 被迫降至1,严重拖慢生成效率,甚至无法加载模型。
建议:优先选择大显存GPU(24GB起步,48GB-96GB为佳),而非单纯追求更高算力的低显存卡。
Q2:CPU在分子设计工作流中是否重要?
分析:CPU在以下环节承担关键角色,不可忽视:
- 数据预处理:SMILES解析、分子描述符计算(RDKit)、数据集清洗——多核并行显著加速
- MD模拟前处理:体系构建、溶剂化、能量最小化——GROMACS/NAMD的前处理阶段CPU密集
- CPU Fallback:当GPU显存不足时,部分框架(如OpenMM)支持CPU回退
- 多任务并发:GPU执行深度学习推理时,CPU可并行处理数据I/O与后处理
建议:选择高主频、多核心的CPU(AMD Threadripper PRO或Intel Xeon W系列),内存通道数≥4,保障CPU-GPU数据供给不成为瓶颈。
Q3:NVMe SSD为何是刚需?
分析:分子设计工作流涉及大量高I/O操作:
- 模型加载:AlphaFold3参数文件>10GB,扩散模型权重通常数GB至数十GB,从SATA SSD加载需数分钟,NVMe仅需数秒
- 分子数据库:ChEMBL、ZINC、Enamine等数据库达数十GB至TB级,随机查询需高IOPS
- MD轨迹存储:微秒级MD轨迹文件可达TB级,分析时需高顺序读写带宽
- 检查点保存:训练/微调过程中频繁保存模型检查点
建议:系统盘与数据盘均采用PCIe 4.0/5.0 NVMe SSD,容量按数据规模规划(入门级2TB+4TB,专业级8TB+,旗舰级16TB+)。
Q4:多GPU配置是否必要?如何选择互联方案?
分析:多GPU的价值体现在:
- 模型并行:单模型超大显存需求(如AlphaFold3复合物、70B+ LLM)可通过张量并行拆分至多卡
- 数据并行:批量分子生成、FEP计算可同时分发至多卡
- 任务并行:结构预测与分子生成可分别占用不同GPU
互联方案选择:
| 场景 | 推荐方案 | 说明 |
|---|---|---|
| 双卡RTX 4090 | NVLink桥接(若主板支持) | 显存池化,单任务显存可达48GB |
| 多卡RTX 6000 Ada | NVLink桥接或PCIe P2P | 专业卡支持更完善的P2P通信 |
| 4卡以上平台 | NCCL + PCIe Switch / NVSwitch | 多卡训练必备,需主板支持多x16通道 |
建议:若预算允许,双卡24GB(NVLink)优于单卡48GB的灵活性;但单卡大显存在模型兼容性上更稳定。
Q5:分子设计工作站是否需要ECC内存?
分析:ECC(Error-Correcting Code)内存可检测并纠正单比特错误,在以下场景具有明确价值:
- 长时间MD模拟:数天至数周的连续运行,内存错误可能导致轨迹损坏
- FEP计算:自由能计算的统计精度对数据完整性敏感
- 多用户共享环境:企业级工作站7×24运行,ECC降低宕机风险
建议:专业级与旗舰级配置强烈建议采用ECC内存;入门级可根据预算灵活选择。
Q6:Linux vs Windows,分子设计工作站该选什么系统?
分析:
| 维度 | Ubuntu Linux 22.04/24.04 LTS | Windows 11 Pro / Windows Server |
|---|---|---|
| CUDA生态 | 原生支持,驱动与工具链更新最快 | 支持,但部分开源工具仅提供Linux版本 |
| 开源软件兼容性 | 绝大多数分子设计工具(GROMACS, RDKit, OpenMM)原生支持 | 部分工具需WSL2或虚拟机,性能有损耗 |
| 商业软件支持 | Schrödinger, MOE等均有Linux版本 | 部分商业软件仅提供Windows版本 |
| Docker/容器化 | 原生支持,便于环境隔离与复现 | WSL2 + Docker Desktop可用,但配置复杂 |
| 远程访问 | SSH原生,VNC/X11转发成熟 | RDP远程桌面体验好,但命令行环境弱 |
| 系统开销 | 低,更多资源留给计算任务 | 较高,后台服务占用内存/CPU |
建议:
- 研发主力工作站:推荐Ubuntu 22.04/24.04 LTS,配合Docker容器化部署各工具环境
- 需要运行Windows专属商业软件:可采用Windows 11 Pro + WSL2双系统方案,或物理双系统
- 企业IT管控环境:Windows Server + WSL2或虚拟机运行Linux工具链
Q7:如何判断现有硬件是否成为瓶颈?
监控指标与诊断方法:
| 瓶颈类型 | 监控指标 | 诊断工具 | 典型症状 |
|---|---|---|---|
| GPU显存不足 | GPU Memory Usage | nvidia-smi, nvtop | OOM错误、batch size无法提升、模型加载失败 |
| GPU算力瓶颈 | GPU Utilization | nvidia-smi dmon | GPU利用率持续>90%,但显存未满 |
| CPU瓶颈 | CPU Usage, Load Average | htop, mpstat | GPU利用率低(<50%),CPU满载 |
| 内存瓶颈 | RAM Usage, Swap Usage | free -h, vmstat | 大量使用Swap,系统卡顿 |
| 存储I/O瓶颈 | Disk I/O, iowait | iostat, nvme-cli | 模型加载慢,数据预处理卡顿 |
| PCIe带宽瓶颈 | PCIe Throughput | nvidia-smi topo -m | 多卡间数据传输慢,NCCL性能低 |
优化建议:
- GPU显存不足 → 升级大显存GPU或启用梯度检查点/激活重计算
- CPU瓶颈 → 增加CPU核心数或优化数据加载pipeline(多进程DataLoader)
- 内存瓶颈 → 扩容内存或采用内存映射(mmap)加载大数据集
- 存储瓶颈 → 升级NVMe SSD或采用RAID 0提升带宽
六、UltraLAB增值服务与交付标准
6.1 预装软件环境(开机即用)
UltraLAB分子设计工作站出厂预装以下环境:
操作系统:Ubuntu 24.04 LTS(可选Windows 11 Pro双系统)
CUDA Toolkit:12.4+
cuDNN:9.1+
Python环境:Miniconda + 独立虚拟环境
  ├─ molgen    : REINVENT, GuacaMol, MoLeR, DiffSBDD
  ├─ md        : GROMACS 2024.x, OpenMM 8.x, AMBER 24
  ├─ structure : AlphaFold3, ColabFold, Boltz-1, Chai-1
  ├─ cheminf   : RDKit, DeepChem, DGL-LifeSci, TorchDrug
  ├─ llm       : Ollama, vLLM, llama.cpp, TensorRT-LLM
  └─ base      : PyTorch 2.3+, JAX, TensorFlow 2.16+
容器环境:Docker + NVIDIA Container Toolkit
开发工具:VS Code, JupyterLab, PyCharm (可选)
6.2 质保与技术支持
| 服务项目 | 内容说明 |
|---|---|
| 整机质保 | 3年原厂部件质保(CPU、主板、内存、SSD、GPU) |
| 上门服务 | 主要城市次日上门,远程7×24技术支持 |
| 软件维护 | 预装环境版本升级指导,Docker镜像更新 |
| 性能调优 | BIOS级超频优化(NUMA、AVX-512、内存时序)、CUDA/GPU性能调优 |
| 扩展升级 | 支持GPU增配、内存扩容、存储扩展,保留升级兼容性 |
七、结语
生成式AI正在重塑分子设计的每一个环节——从靶点发现到先导优化,从蛋白质工程到ADMET预测。2026年,扩散模型与Transformer化学语言模型的成熟,使得"AI设计分子→物理验证"的闭环成为现实。然而,算法的突破需要硬件的承载:大显存GPU支撑3D分子生成,高速NVMe SSD保障数据流,多核CPU协调复杂工作流。
UltraLAB深耕科学计算硬件定制领域,针对AI分子设计的独特计算特征,提供从入门级到旗舰级的全系列工作站方案。无论您是高校课题组探索算法前沿,还是药企研发部门推进管线项目,UltraLAB均可为您提供开箱即用、性能调优、售后无忧的一站式硬件解决方案。
即刻联系UltraLAB技术团队,获取专属分子设计工作站配置方案。
关于UltraLAB
UltraLAB是西安坤隆计算机科技有限公司旗下高端定制图形工作站品牌,专注为科学计算、工程仿真、AI训练与推理等场景提供超频硬件配置方案。我们深谙ANSYS、COMSOL、GROMACS、AlphaFold等科学计算软件的硬件需求,致力于以极致性能加速科研与产业创新。
官网:www.xasun.com | 咨询热线:400-705-6800


