






一、从"手动调参"到"AI代驾":硅光设计的新范式
硅光子学(Silicon Photonics)被誉为后摩尔时代的"光互联"钥匙。一颗指甲盖大小的硅光芯片上,集成了激光器、调制器、波导、分束器、探测器等数十种光学元件。其中,1×2 MMI(多模干涉)分束器是最基础也最关键的无源器件之一——它要把一束光精准地分成两束50:50的能量,误差直接决定整个光链路的信噪比。
传统设计流程中,工程师需要手动翻阅文献、推导拍长公式、在Lumerical里逐层画结构、调网格、跑仿真、看结果、再优化。一个MMI的设计,往往要经历"建模3小时,仿真1小时,调参一整天"的循环。
而现在,一篇实战教程向我们展示了另一种可能:让AI智能体Codex自己读文献、自己写脚本、自己跑Lumerical、自己看结果。工程师的角色,从"操作工"变成了"指挥官"。
二、五大核心计算环节:AI如何"自学"硅光仿真
整个流程可拆解为五个环环相扣的计算环节,每个环节都体现了AI Agent与传统仿真的深度融合:
环节1:环境感知与自主规划(AI Agent层)
Codex接到指令后,不会立刻盲目动手,而是先执行"工程盘点":
-
扫描项目目录,确认参考文献PDF存在;
-
提取文献中的MMI自成像公式(拍长公式 Lπ=3λ4nrW2 )与经验尺寸;
-
验证Ansys Lumerical 2026 R1安装路径及Python/API环境;
-
定位PyEDAT库的正确安装源,避免与同名库冲突。
计算特点:这一阶段以文件I/O、文本解析、逻辑推理为主,对CPU单核性能与内存响应速度敏感。
环节2:自动几何建模(Lumerical FDTD层)
AI基于文献参数和工艺约束,自动生成
.fsp 工程文件,包含:
-
FDTD仿真区域:网格规模达 808×164×68.1 (三维);
-
MMI多模干涉区:核心功能区域,需支持多模传播与自成像;
-
Input/Output Taper:输入/输出锥形波导,降低模场失配损耗;
-
TE0光源:C波段(~1550nm)TE基模激励;
-
Core Mesh:核心区域网格加密,确保场分布精度。
计算特点:几何建模本身计算量不大,但网格划分质量直接决定后续FDTD求解的精度与效率。MMI区宽度通常在数微米至十几微米,而波导厚度仅220nm,宽高比极大,对非均匀网格策略要求极高。
环节3:FDTD全波仿真求解(电磁计算核心)
Lumerical FDTD采用时域有限差分法(Finite-Difference Time-Domain),直接离散求解麦克斯韦方程组:
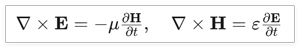
对于硅基1×2 MMI,仿真需追踪光波在多模区中的传播、干涉、自成像,并在输出端口分析分光比。
计算特点:
-
显式时域推进:时间步长受CFL条件限制(Δt≤Δx/c3 ),需数万至数百万时间步;
-
大网格规模:即使基础模型已达 808×164×68≈900 万网格点,若进行参数化扫描(如MMI宽度、长度、锥形角度),总计算量呈指数级增长;
-
材料色散:C波段硅的折射率随波长变化,需引入Sellmeier模型或实测材料数据;
-
TE模式偏振敏感:仅需TE0基模,但多模区会激发高阶模,需足够大的仿真区域避免边界反射。
环节4:结果提取与自动分析(AI后处理层)
仿真完成后,AI自动提取:
-
输出端口透射率/插入损耗(目标 < 0.5 dB);
-
分光比(目标 50:50,误差 < ±1%);
-
模场分布与自成像位置验证。
若结果偏离文献基准(如Zhen Sheng 2012实测的49:51分光比),AI会回溯检查几何参数、网格精度或材料设置,进入迭代优化循环。
环节5:参数化扫描与优化(可选扩展)
进阶应用中,可结合Lumerical的Optimization Toolbox或Python脚本,对MMI长度、宽度、锥形角度进行自动扫描,寻找最优设计点。
三、计算特点总结:为什么硅光仿真"既吃CPU又吃GPU"?
表格
| 维度 | 具体表现 | 硬件影响 |
|---|---|---|
| 网格密度 | 纳米级厚度(220nm)与微米级宽度(~10μm)共存,需非均匀网格加密 | 内存容量决定最大可算网格数 |
| 时域步数 | 光在MMI区传播需经历数万至数十万个时间步 | CPU/GPU核心数决定单案例求解速度 |
| 多模干涉 | 需同时追踪基模+高阶模的相位叠加,对相位精度敏感 | 双精度浮点性能影响结果可靠性 |
| 材料色散 | C波段宽谱仿真需多点波长扫描 | 批量计算对并行算力需求大 |
| AI Agent开销 | Codex持续运行PDF解析、代码生成、GUI操控 | 额外占用内存与CPU资源,需独立预留 |
四、软件工具链:从"AI大脑"到"仿真引擎"的全栈清单
表格
| 层级 | 工具 | 作用 |
|---|---|---|
| AI Agent | Codex(OpenAI桌面版) | 核心"驾驶员",自主规划、读文献、写脚本、操控Lumerical GUI |
| 模型切换 | CC Switch | 支持OpenAI/Anthropic/DeepSeek/智谱等50+模型热切换,避免单供应商依赖 |
| 光子仿真 | Ansys Lumerical 2026 R1 | FDTD Solutions(全波电磁仿真)、MODE(波导模式分析)、INTERCONNECT(系统级链路仿真) |
| 自动化接口 | PyEDAT + Python | Codex通过Python API远程控制Lumerical,实现脚本化建模与批量仿真 |
| 文献支撑 |
Soldano & Pennings 1995(MMI自成像理论) Zhen Sheng 2012(CMOS工艺实测数据) |
为AI提供物理公式约束与结果校验基准 |
五、硬件配置推荐:让AI跑Lumerical不"卡顿"
硅光FDTD仿真+AI Agent同时运行,对硬件有双重压力。以下是三类推荐配置:
方案A:个人学习/轻量设计
相关机型 UltraLAB A330 或AR330
表格
| 组件 | 推荐配置 |
|---|---|
| CPU | Intel Core i7-14700K / AMD Ryzen 7 7700X(8P+12E核,高主频利于AI响应与单案例FDTD) |
| 内存 | 64GB DDR5-5600(双通道,基础MMI模型约占用20-30GB,预留Codex与系统开销) |
| 存储 | 1TB NVMe SSD(快速加载Lumerical工程与文献PDF) |
| 显卡 | RTX 4070 12GB(支持Lumerical GPU加速,显存满足中等规模网格) |
| 系统 | Windows 11 Pro(Codex桌面版目前对Windows支持最佳) |
方案B:企业研发/中等规模
相关机型 UltraLAB A330 或AR330
表格
| 组件 | 推荐配置 |
|---|---|
| CPU | Intel Core i9-14900K / AMD Ryzen 9 7950X(16核32线程,支持多参数并行扫描) |
| 内存 | 128GB DDR5-6000(四通道或双通道高容量,支持百万级网格+多案例驻留) |
| 存储 | 2TB NVMe SSD + 4TB HDD(SSD放活跃项目,HDD归档历史仿真数据) |
| 显卡 | RTX 4070 Ti Super 16GB / RTX A4000 16GB(大显存支持复杂三维模型GPU加速) |
| 散热 | 360mm一体式水冷(FDTD长时间满载,温度稳定保障不降频) |
| 显示器 | 双屏27英寸 2K(一屏Lumerical GUI,一屏Codex对话与代码监控) |
方案C:专业硅光设计工作站
相关机型 UltraLAB AX430 或AE450
表格
| 组件 | 推荐配置 |
|---|---|
| CPU |
Intel Xeon W-3400系列(如W7-3465X,28核56线程,AVX-512加速浮点运算) 或 AMD Threadripper PRO 7000 WX(24核48线程起,超大内存带宽) |
| 内存 | 256GB–512GB ECC DDR5(ECC纠错保障长时间批量仿真不崩溃,大容量支持千万级网格) |
| 存储 | 2TB NVMe SSD(系统+软件)+ 4TB NVMe SSD(活跃项目高速读写)+ 8TB HDD(归档) |
| 显卡 | RTX 5000 Ada 32GB / RTX A6000 48GB(专业驱动认证,超大显存支持多波长/多结构并行GPU求解) |
| 网络 | 万兆网卡(团队共享仿真数据与许可证服务器) |
| 系统 | Windows 11 Pro for Workstations(Codex兼容)+ 可选WSL2/Linux子环境 |
六、典型应用场景:谁需要这套"AI+硅光"组合拳?
表格
| 场景 | 需求描述 |
|---|---|
| 硅光芯片无源器件设计 | MMI分束器、定向耦合器、微环谐振器、光栅耦合器的快速建模与优化 |
| 光通信C波段器件开发 | 数据中心光互连、400G/800G光模块中的硅光集成元件设计 |
| 220nm SOI标准工艺适配 | 与台积电、GlobalFoundries等硅光工艺线的设计规则对接 |
| 学术研究与教学 | 高校硅光实验室利用AI Agent降低Lumerical学习门槛,加速论文迭代 |
| AI辅助光子逆向设计 | 结合拓扑优化与神经网络,由AI自动探索非传统结构(如弯曲MMI、多段taper) |
七、写在最后:AI不会取代光子工程师,但会取代"不会用AI"的光子工程师
当Codex能在48秒内读完两篇奠基文献、自动安装PyEDAT、生成FDTD模型并跑通仿真,硅光设计的门槛正在被重新定义。工程师的核心价值,不再是记住拍长公式或手动拖拽几何体,而是提出正确的问题、设定合理的约束、判断AI输出的物理合理性。
从"手动调参"到"AI代驾",变的不是物理定律,而是人与工具的协作方式。在硅光芯片竞争日益激烈的今天,算得快、迭代快、验证快,就是产品上市的核心竞争力。
如需针对您的硅光仿真规模(MMI尺寸、网格密度、参数扫描数量)定制最优工作站配置,欢迎咨询UltraLAB专业图形工作站,我们为光子芯片设计团队提供从"个人学习机"到"企业级算力集群"的全栈硬件方案。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


