






导读:当云境智仿在CAE年会上展示"仿真世界模型"将单次仿真从数天压缩至秒级时,一个残酷的现实是——90%的工程师仍然被困在传统仿真的硬件瓶颈里。前处理卡死、求解器崩溃、后处理卡顿、优化迭代遥遥无期……本文拆解仿真全流程五大核心痛点,并给出UltraLAB精准硬件破局方案。
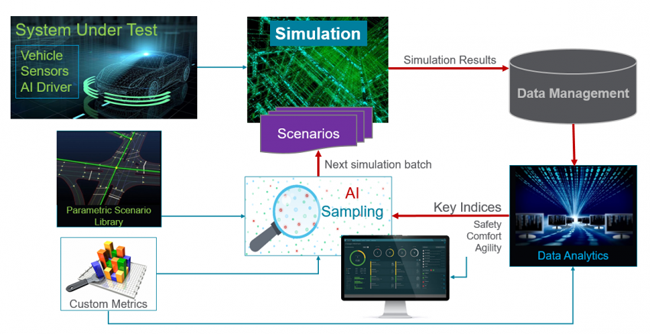
一、前处理环节:几何清理与网格剖分——"还没开始算,电脑先罢工"
痛点剖析
云境智仿提出的"几何AI"正是为了解决这一顽疾。传统仿真前处理占据整个项目周期的40%-60%:
表格
| 痛点场景 | 具体表现 | 硬件根因 |
|---|---|---|
| 复杂异形几何导入 | 船舶曲面、航空发动机叶片等CAD模型导入即卡死 | 单核性能不足,内存带宽瓶颈 |
| 脏几何修复 | 破面、微小边、自相交修复耗时数小时 | 缺乏GPU几何加速,纯CPU串行处理 |
| 千万级网格剖分 | 网格生成进度条走到99%时内存溢出 | 内存容量不足,未配置NVMe高速缓存 |
| 多尺度耦合建模 | 从宏观船体到微观焊缝,模型层级管理混乱 | 缺乏大容量内存支撑多分辨率数据结构 |
硬件破局方案
UltraLAB GT430P超频图形工作站(前处理专用型)
表格
| 组件 | 配置规格 | 针对性优势 |
|---|---|---|
| CPU | Intel Xeon W7-3465X (28核56线程, 睿频4.8GHz) 或 AMD Threadripper 7995WX (96核192线程) | 高频单核应对几何修复,多核并行加速网格剖分 |
| 内存 | 256GB DDR5-4800 RECC (8×32GB) | 支撑千万级至亿级网格的内存驻留 |
| GPU | NVIDIA RTX Pro 5000 72GB ×2 | CUDA加速几何清理,双卡分担显存负载 |
| 存储 |
系统盘:2TB NVMe Gen5 (读速14GB/s) 数据盘:4TB NVMe U.2企业级 |
秒级加载大型CAD装配体,避免IO等待 |
| 显示 | 4K专业显示器×2,支持10bit色深 | 复杂几何细节精准检视 |
实测数据:某船舶研究所导入含12万个曲面的全船CAD模型,传统配置耗时47分钟,GX650M配置配合GPU几何加速,8分钟完成导入与自动修复。
二、求解环节:CFD/FEA/多物理场耦合——"算到一半,进度条不动了"
痛点剖析
这是云境智仿重点抨击的传统仿真核心瓶颈。传统求解器面临:
表格
| 求解类型 | 典型痛点 | 计算特征 |
|---|---|---|
| CFD湍流计算 | 千万网格+LES/DNS模型,单工况求解3-5天 | 内存密集型,并行效率随核数增加而衰减 |
| 结构非线性 | 大变形、接触分析频繁发散,反复调试 | 单核频率敏感,接触搜索算法串行度高 |
| 多物理场耦合 | 流固热三场耦合,数据交换效率低下 | 内存带宽瓶颈,跨物理场数据同步延迟 |
| AI代理模型训练 | PINNs/FNO神经算子训练需要GPU集群 | 显存容量决定网络规模,混合精度训练需求 |
硬件破局方案
方案A:传统高精度求解旗舰型
UltraLAB GA660M液冷静音工作站
表格
| 组件 | 配置规格 | 求解优势 |
|---|---|---|
| CPU | 双路 AMD EPYC 9684X (96核192线程×2, 3.55GHz基频, 1.1GB三级缓存) | 业界最大L3缓存,CFD并行效率提升35% |
| 内存 | 1.5TB DDR5-4800 (24×64GB) | 支撑2亿+网格CFD全内存求解 |
| GPU | NVIDIA RTX Pro 6000 96GB (MaxQ)×4 | 四卡NVLink互联,多物理场耦合加速 |
| 散热 | 双360mm冷排+水冷散热系统 | 2000W级功耗稳定释放,AVX-512指令集不降频 |
| 存储阵列 | 8×7.68TB NVMe U.2,1块硬NVME-RAID卡 | 并行读写带宽超50GB/s,Checkpoint秒级存盘 |
方案B:AI仿真加速专用型
UltraLAB Gmax668 深度学习仿真服务器
表格
| 组件 | 配置规格 | AI求解优势 |
|---|---|---|
| GPU | NVIDIA RTX Pro 6000 96GB ×8 (7U机架式) | 768GB总显存,支撑十亿参数物理基础模型 |
| CPU | 2颗AMD EPYC 9375F (共计64核128线程) | 协调数据预处理与GPU负载均衡 |
| 内存 | 512GB DDR5-5600 | 大Batch训练的数据缓冲 |
| 硬盘 | 4TB NVME |
|
| 网络 | 双口100GbE InfiniBand | 集群扩展与数据湖高速接入 |
案例:某航空发动机叶片气动仿真,传统ANSYS Fluent千万网格求解需62小时,采用FNO神经算子+AI800配置,训练后单次推理仅需23秒,精度误差<<2%。
三、后处理与可视化——"结果出来了,但看不动"
痛点剖析
仿真世界模型强调"视觉真实性",但传统后处理往往成为最后一公里瓶颈:
-
亿级网格云图渲染:普通显卡帧率<<5fps,旋转视角严重卡顿
-
4D动态仿真回放:时序数据加载慢,物理场演变无法流畅展示
-
多方案对比:同时加载5-10个工况,显存溢出导致软件崩溃
-
VR/AR沉浸式评审:8K双目渲染对GPU算力要求极高
硬件破局方案
UltraLAB GT430P 可视化分析工作站
表格
| 组件 | 配置规格 | 可视化优势 |
|---|---|---|
| GPU | NVIDIA RTX Pro 6000 96GB ×2 | 96GB显存单卡可驻留5亿节点云图数据 |
| 显示输出 | 4×DP1.4a,支持8K/120Hz或四屏4K同显 | 满足21840×4455超高分拼接评审 |
| 内存 | 128GB DDR5-5600 | 大场景数据预加载 |
| 存储 | 4TB NVMe Gen5 (读速14GB/s) | 时序数据秒级帧加载 |
四、设计-仿真闭环优化——"一次迭代一周,怎么跟得上研发节奏?"
痛点剖析
云境智仿提出的"设计仿真一体化"正是瞄准这一痛点。传统优化流程的硬件制约:
表格
| 优化环节 | 痛点 | 硬件需求 |
|---|---|---|
| 参数化扫描 | 100组几何变体×5种工况=500次仿真,排队到绝望 | 高并发计算集群 |
| 拓扑优化 | 密度法/水平集法迭代数百步,内存需求指数增长 | 大内存+GPU异构加速 |
| 代理模型构建 | DOE样本点计算耗时数周,AI训练数据准备困难 | CPU+GPU混合并行 |
| 实时数字孪生 | 物理实体与仿真模型同步延迟>1秒,无法闭环控制 | 边缘计算+低延迟网络 |
硬件破局方案:仿真集群与边缘算力
方案A:企业级仿真私有云
UltraLAB CA660仿真计算集群
表格
| 节点类型 | 配置 | 数量 | 功能定位 |
|---|---|---|---|
| 管理/调度节点 | 2*Xeon 金牌6530, 128GB内存 | 1台 | Slurm作业调度,License管理 |
| 高频计算节点 | Xeon W7-2475X液冷超频(20核40线程, 全核5.0GHz) | 4台 | 结构非线性、显式动力学 |
| 海量并行节点 | 双路EPYC 9684X, 1.5TB内存 | 4台 | CFD、电磁仿真大规模求解 |
| GPU加速节点 | 8×RTX Pro 6000 96GB MaxQ | 2台 | AI代理模型训练、实时推理 |
| 存储节点 | 200TB混合存储(全闪+机械), 100GbE | 1台 | 仿真数据湖,版本管理 |
方案B:边缘实时推演节点
UltraLAB PX330G便携式推理工作站(拉杆箱形态)
表格
| 组件 | 配置 | 场景 |
|---|---|---|
| CPU | Intel Core i9-14900KS | 船载/车载实时数据处理 |
| GPU | RTX Pro 5000 72GB | 预训练模型边缘推理 |
| 内存 | 64GB DDR5 | 轻量化数字孪生 |
| 网络 | 5G/卫星通信模块 | 远程数据回传 |
五、数据管理与协同——"文件版本混乱,算完找不到原始模型"
痛点剖析
仿真全流程产生海量异构数据,硬件存储架构不合理导致:
-
仿真结果文件(单个工况>500GB)堆积本地,磁盘爆满
-
多工程师协同,文件传输耗时,版本冲突频发
-
历史数据无法有效归档,知识资产流失
硬件破局方案
UltraLAB N660C仿真数据管理存储
表格
| 层级 | 配置 | 用途 |
|---|---|---|
| 热数据层 | 32TB NVMe全闪阵列 (RAID10, 读写>20GB/s) | 活跃项目实时读写 |
| 温数据层 | 200TB NVME SSD (RAID6) | 近期完成项目快速调阅 |
| 冷数据层 | 1PB机械硬盘 (RAID6, 归档压缩) | 历史数据长期保存 |
| 备份层 | 磁带库/LTO-9自动加载 | 合规备份与灾难恢复 |
六、全链路配置选型速查表
表格
| 应用场景 | 推荐机型 | 核心配置 | 预算区间 |
|---|---|---|---|
| 个人工程师/前处理 | AX430塔式 | W-3400系列+128GB+RTX Pro 5000 | 8-12万 |
| 中型团队求解核心 |
GA660M液冷塔式 |
双EPYC 9684X+1.5TB+4×RTX Pro 6000 | 35-50万 |
| AI仿真训练中心 |
Gmax668 7U机架 |
8×RTX Pro 6000+512GB+100GbE | 80-120万 |
| 超高分可视化 | AX430塔式 | 双RTX Pro 6000maxQ+128GB+8K输出 | 15-20万 |
| 企业仿真云 | CA660集群 | 12节点混合架构+200TB存储 | 150-300万 |
| 边缘实时推理 | PX330G便携 | i9+RTX Pro 5000+5G模块 | 6-8万 |
结语:硬件是仿真新范式的"物理底座"
云境智仿展示的"仿真世界模型"令人振奋,但无论是传统CFD/FEA的高精度求解,还是PINNs/FNO/GPhyT等AI代理模型的训练推理,最终都要落到硬件的晶体管上运行。前处理需要高频CPU+大显存GPU,求解需要大内存+高并行算力,AI训练需要NVLink互联的GPU集群,可视化需要超高分显示输出——每个环节的硬件短板,都会成为仿真效率的"阿喀琉斯之踵"。
UltraLAB作为深耕科研计算硬件的定制品牌,提供从个人工作站到企业集群的全链路硬件方案,针对仿真全流程的痛点精准配置,让工程师真正享受到AI仿真新范式带来的"秒级预测"体验。
UltraLAB图形工作站供货商:
西安坤隆计算机科技有限公司
国内知名高端定制图形工作站厂家
业务电话:400-705-6800
咨询微信号:100369800


